Workshop: ลอง Gemini 3.8 Flash TTS กับ Flash-Lite TTS ให้พูดไทยจริง ต่างกันแค่ไหน คุ้มตัวไหน
ภาพประกอบในบทความ: การ์ดเปิดตัวและกราฟผลทดสอบจาก Google Blog (ใช้เพื่อการรายงานข่าว), ภาพหน้าจอเอกสารจาก Google AI for Developers ที่ผมแคปเอง ส่วนภาพ terminal และไฟล์เสียงทั้งหมดมาจากการรันจริงของผม
Google ปล่อยโมเดลแปลงข้อความเป็นเสียง (TTS — Text-to-Speech) รุ่นใหม่สองตัวเมื่อ 23 ก.ย. 2026 คือ Gemini 3.8 Flash TTS กับ Gemini 3.8 Flash-Lite TTS ผมเลยจับทั้งคู่มาพูดภาษาไทยด้วยสคริปต์เดียวกัน วัดเวลา ดูบิลจริงทีละคำขอ แล้วถอดเสียงกลับเป็นข้อความเพื่อเช็กว่าฟังรู้เรื่องไหม
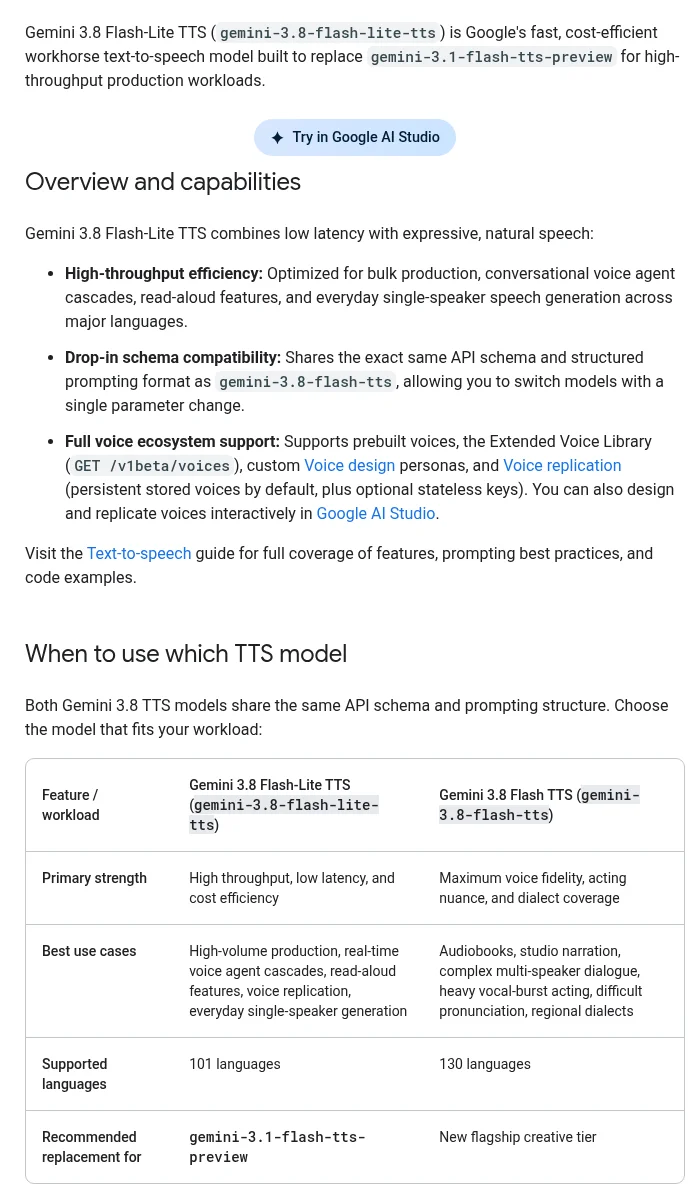
จุดที่ผมว่าสำคัญที่สุดและหลายคนอาจพลาด: ตามเอกสารทางการ ภาษาไทยอยู่ในลิสต์ของ Flash TTS แต่ไม่อยู่ในลิสต์ของ Flash-Lite TTS — ทั้งที่ในการทดลองของผม Flash-Lite ก็พูดไทยออกมาได้ อ่านจบบทนี้จะรู้ว่าควรเลือกตัวไหน
ชื่อที่ถูกต้องคือ “Gemini 3.8” (ไม่ใช่ “gemnini”) model ID ที่ใช้เรียก API คือ
gemini-3.8-flash-ttsและgemini-3.8-flash-lite-ttsถ้าอยากอ่านข่าวเปิดตัวแบบสรุปก่อน ผมเคยเขียนไว้ที่ Gemini 3.8 Flash TTS + Flash-Lite TTS: สร้างเสียงตัวละครด้วยพรอมป์ บทนี้คือภาคลงมือทำครับ
ภาพ: Google / Google Blog
สรุป 30 วินาที
- เปิดตัว 23 ก.ย. 2026 ใช้ได้แล้วใน Gemini API และ Google AI Studio (ฝั่ง Gemini Enterprise ยัง “coming soon”) ตาม ประกาศของ Google และ LiteLLM ระบุว่าทั้งสองตัวเป็น GA (ใช้งานจริงได้ ไม่ใช่ preview) มาแทน
gemini-3.1-flash-tts-preview - Flash TTS = ตัวท็อป เน้นเสียงละเอียด แสดงอารมณ์ สำเนียง ออกเสียงคำยาก รองรับ 130 ภาษา (มีไทย)
- Flash-Lite TTS = ตัวคุ้ม เน้นเร็ว ถูก งานปริมาณมาก รองรับ 101 ภาษา (ไม่มีไทยในลิสต์)
- ราคา (Standard, ถึง 31 ธ.ค. 2026): input ข้อความ $0.50 ต่อล้านโทเคนเท่ากัน ส่วน output เสียง Flash $9 vs Flash-Lite $6 ต่อล้านโทเคน และ ราคาจะขึ้นเป็นสองเท่าตั้งแต่ 1 ม.ค. 2027
- ผลทดลองของผม: ประโยคไทยยาว ~11 วินาที Flash ใช้ $0.0033 ต่อคำขอ Flash-Lite $0.0022 ถูกกว่าราว 1 ใน 3 และตอบเร็วกว่าราว 1 วินาที ถอดเสียงกลับได้ข้อความไทยถูกเกือบครบทั้งคู่
ทำไมเรื่องนี้เกี่ยวกับคุณ
ถ้าคุณทำคลิป YouTube, พอดแคสต์, หนังสือเสียง, แชตบอตที่ต้องพูดได้ หรือระบบอ่านออกเสียงบนเว็บ — TTS คือ “นักพากย์ที่จ้างเป็นรายวินาที” การเลือกผิดตัวมีผลทั้งเงินและคุณภาพ
- คนทำคอนเทนต์ภาษาไทย: ตัวที่ Google รับรองว่ารองรับไทยคือ Flash TTS ตัวเดียว ถ้าใช้ Flash-Lite กับงานไทย คุณกำลังใช้นอกขอบเขตที่เอกสารรับรอง วันหนึ่งผลอาจเปลี่ยนโดยไม่มีใครเตือน
- ทีมที่ทำ voice agent หรืออ่านออกเสียงจำนวนมาก: Flash-Lite ถูกกว่า 1 ใน 3 ในฝั่งเสียง output ซึ่งเป็นก้อนหลักของบิล (ในการทดลองของผม ค่า input ไม่ถึง 1% ของบิล)
- คนที่ยังใช้
gemini-3.1-flash-tts-preview: รูปแบบคำขอเปลี่ยน ต้องย้ายคำกำกับการพูดออกจากข้อความ (อธิบายด้านล่าง)
ทำงานยังไง: นักพากย์ที่อ่านบท “ตามตัวอักษร”
นึกภาพห้องอัดเสียงที่มีนักพากย์สองคน คนแรก (Flash) เป็นนักพากย์ละครเวทีที่เล่นได้ทุกอารมณ์และทุกสำเนียง ค่าตัวแพงกว่า คนที่สอง (Flash-Lite) เป็นนักพากย์สายโฆษณาที่อ่านเร็ว เนียน ราคาเป็นมิตร แต่ถนัดภาษาน้อยกว่า
ทั้งสองคน อ่านบทแบบคำต่อคำ — เอกสาร Text-to-speech guide บอกชัดว่า Gemini 3.8 TTS มองข้อความที่ส่งไปเป็น “transcript ตามตัวอักษร” ถ้าคุณเขียนว่า “พูดอย่างร่าเริง: สวัสดี” มันอาจอ่านคำว่า “พูดอย่างร่าเริง” ออกมาด้วย วิธีที่ถูกคือแยกเป็นสามชั้น:
| ชั้น | ใส่ตรงไหน | ตัวอย่าง |
|---|---|---|
| อารมณ์/สไตล์ทั้งประโยค | style ใน speech_metadata (ผ่าน AI Gateway คือ instructions หรือ speechMetadata.style) | "cheerful and friendly", "speaking slowly" |
| เสียงเฉพาะจุด | แท็กในวงเล็บมุม <...> แทรกในข้อความ (แนะนำให้ใช้แท็กภาษาอังกฤษแม้บทเป็นภาษาอื่น) | <laughs>, <sigh> |
| คนฟังแทรก (backchannel) | ครอบด้วย ` | … |
ความสามารถหลักที่ Google ประกาศ และ เอกสาร ยืนยัน:
- เสียงสำเร็จรูป 30 เสียง (เช่น Kore, Puck, Fenrir, Schedar) และ Extended Voice Library อีกหลายร้อยเสียงผ่าน
GET /v1beta/voices— บล็อกของ Google ใช้คำว่า 2,000+ เสียง - Voice design สร้างเสียงใหม่จากคำบรรยาย และ Voice replication โคลนเสียงจากตัวอย่าง ~30 วินาที ต้องมีคลิปยินยอมจากเจ้าของเสียง (ฟีเจอร์โคลนเสียงใน AI Studio ยังไม่เปิดในบางพื้นที่ เช่น EEA, UK, India, Illinois, Texas)
- บทสนทนา 2 คนในคำขอเดียว (สูงสุด 2 speaker ด้วยเสียงสำเร็จรูป)
- เสียงทุกคลิปฝังลายน้ำ SynthID ที่หูไม่ได้ยิน เพื่อให้ตรวจได้ว่าเป็นเสียงจาก AI
- ขีดจำกัดต่อคำขอ: input 8,192 โทเคน, output 16,384 โทเคน ไม่รองรับ Live API, function calling หรือ thinking (model page)
- คำขอแบบปกติได้ไฟล์ WAV มี header พร้อมใช้ (24 kHz, mono, 16-bit) ไม่ต้องห่อ PCM เองเหมือนรุ่นก่อน
ภาพหน้าจอ: Google AI for Developers แคปเมื่อ 26 ก.ย. 2026
เทียบสเปกแบบตารางเดียวจบ
| Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS | |
|---|---|---|
| Model ID | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| สถานะ | GA, เปิดตัว 23 ก.ย. 2026 | GA, เปิดตัว 23 ก.ย. 2026 |
| จุดเด่น (ตามเอกสาร) | เสียงละเอียด แสดงอารมณ์ สำเนียง คำยาก | เร็ว ถูก งานปริมาณมาก |
| จำนวนภาษา | 130 | 101 |
| ภาษาไทยในลิสต์ทางการ | ✅ มี | ❌ ไม่มี |
| บทสนทนา 2 คน / Voice design / Voice replication | ✅ / ✅ / ✅ | ✅ / ✅ / ✅ |
| ราคา input ข้อความ (Standard, ถึง 31 ธ.ค. 2026) | $0.50 / 1M tokens | $0.50 / 1M tokens |
| ราคา output เสียง (Standard, ถึง 31 ธ.ค. 2026) | $9.00 / 1M tokens | $6.00 / 1M tokens |
| ราคาตั้งแต่ 1 ม.ค. 2027 | $1.00 in / $18.00 out | $1.00 in / $12.00 out |
| Batch / Flex | ครึ่งราคา | ครึ่งราคา |
| Free tier (Standard) | มี (ฟรีทั้ง input/output แต่ข้อมูลถูกใช้พัฒนาผลิตภัณฑ์) | มี |
| ค่าที่ผมวัดได้: ไทย ~11 วินาที | 5.3 วิ (มัธยฐาน 4 รอบ), $0.0033 | 4.4 วิ (มัธยฐาน 4 รอบ), $0.0022 |
ที่มาของราคาคือ หน้า pricing ซึ่งตรงกับตัวเลขที่ LiteLLM และ Vercel AI Gateway ใช้ เทียบกับรุ่นก่อน gemini-3.1-flash-tts-preview ที่ $1.00 in / $20.00 out ถือว่าลดลงมากในช่วงนี้
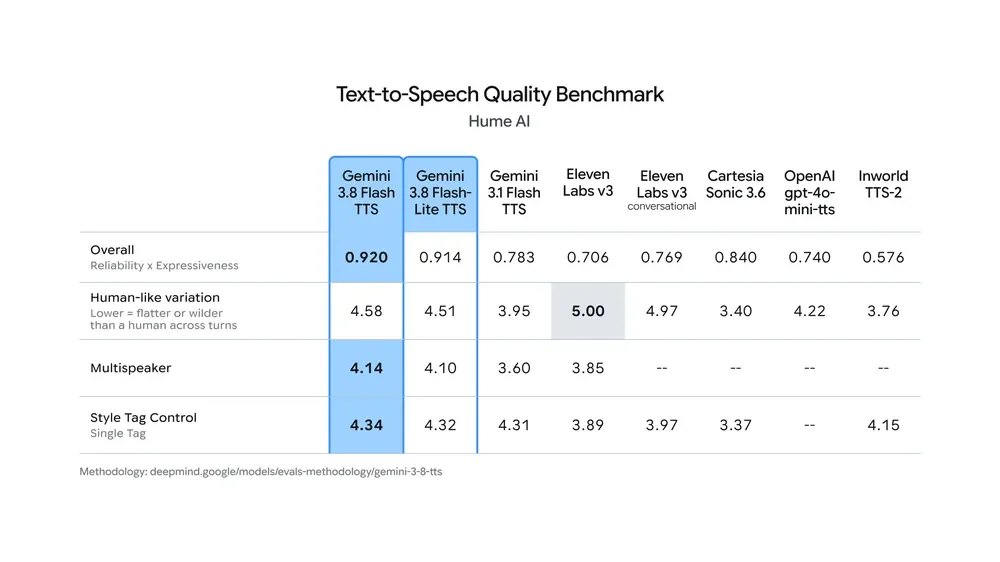
ฝั่งคุณภาพ Google อ้างผลทดสอบของบุคคลที่สาม: Flash TTS ได้อันดับ 1 และ Flash-Lite อันดับ 2 ใน Overall Quality ของ Hume AI (0.920 vs 0.914) — ห่างกันนิดเดียว ส่วนการโหวตแบบฟังเทียบ (Voice Arena) Flash-Lite ชนะ Flash ในภาษาอังกฤษ โปรตุเกสบราซิล และเวียดนามด้วยซ้ำ แต่ไม่มีภาษาไทยในกราฟ และนี่คือตัวเลขที่ Google เลือกมาแสดงเอง
ภาพ: Google / Google Blog
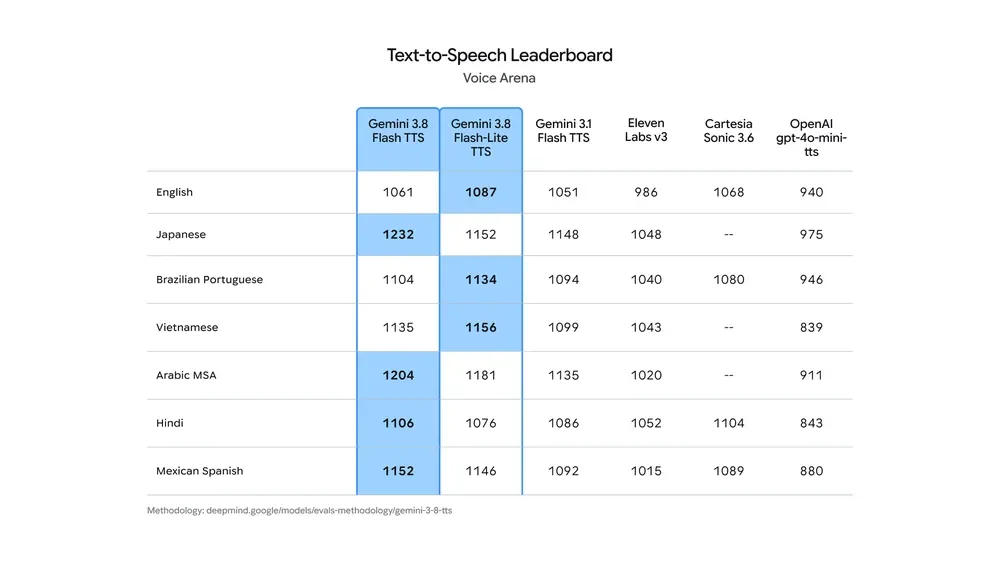
ภาพ: Google / Google Blog
Workshop: ลงมือเทียบเอง
เตรียมของ
ผมไม่ได้ใช้ Gemini API key ตรง แต่เรียกผ่าน Vercel AI Gateway ซึ่ง ประกาศรองรับสองรุ่นนี้ตั้งแต่วันเปิดตัว ข้อดีคือได้ค่าใช้จ่ายของแต่ละคำขอกลับมาใน response เลย เหมาะกับการเทียบราคา
สิ่งที่ต้องมี:
- Node.js 22.18 ขึ้นไป (รันไฟล์
.tsได้เลย) หรือ Bun AI_GATEWAY_API_KEYจาก Vercel dashboard (ห้าม commit ลง git)- ffmpeg (ไม่บังคับ ใช้แปลงเป็น MP3)
ถ้าอยากเรียก Gemini API ตรง ให้สร้าง key ใน Google AI Studio แล้วใช้ endpoint generativelanguage.googleapis.com/v1beta/interactions ตาม คู่มือ TTS — รูปแบบ JSON ต่างจาก Gateway เล็กน้อย รอบนี้ผมไม่ได้ทดสอบเส้นทางนั้น
ขั้นที่ 1: เรียกเสียงพูดคนเดียว
โค้ดส่วนนี้ต้องใช้ network และ API key จึงเป็น ตัวอย่างบางส่วน (fragment) ที่ตัดมาจากสคริปต์เต็มที่ผมรันจริง:
const res = await fetch('https://ai-gateway.vercel.sh/v4/ai/speech-model', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.AI_GATEWAY_API_KEY}`,
    'ai-gateway-protocol-version': '0.0.1',
    'ai-speech-model-specification-version': '4',
    'ai-model-id': 'google/gemini-3.8-flash-tts', // หรือ google/gemini-3.8-flash-lite-tts
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
    text: 'สวัสดีครับ ผมน้องกายจาก Showkhun Lab ...',
    voice: 'Puck',
    instructions: 'friendly, upbeat, casual Thai YouTuber', // สไตล์ ไม่ถูกอ่านออกเสียง
    outputFormat: 'wav',
  }),
});
const json = await res.json();
await writeFile('out.wav', Buffer.from(json.audio, 'base64')); // มี WAV header แล้ว
console.log(json.providerMetadata.gateway.cost); // ค่าใช้จ่าย USD ของคำขอนี้
สิ่งที่พลาดง่าย: ถ้าไม่ใส่ header ai-gateway-protocol-version จะได้ error Unsupported gateway protocol version (ผมโดนมาแล้วครับ)
ขั้นที่ 2: บทสนทนา 2 เสียง
ใส่ข้อความเป็น turns ทีละประโยค ระบุ speaker ทุกประโยคให้ตรงกับที่ตั้งเสียงไว้ และปล่อย text เป็นค่าว่าง (fragment):
const body = {
  text: '',
  outputFormat: 'wav',
  providerOptions: {
    google: {
      multiSpeakerVoiceConfig: {
        speakerVoiceConfigs: [
          { speaker: 'Flash', voiceConfig: { prebuiltVoiceConfig: { voiceName: 'Puck' } } },
          { speaker: 'Lite', voiceConfig: { prebuiltVoiceConfig: { voiceName: 'Kore' } } },
        ],
      },
      turns: [
        { text: 'ผม Flash ครับ เสียงละเอียด เล่นใหญ่ได้เต็มที่', speechMetadata: { speaker: 'Flash', style: 'proud, dramatic' } },
        { text: 'ส่วนผม Lite ครับ เร็วกว่า ถูกกว่า <laughs> แต่ภาษาไทยไม่อยู่ในลิสต์ทางการนะ', speechMetadata: { speaker: 'Lite', style: 'cheeky, fast' } },
        { text: 'อ้าว แล้วที่พูดอยู่นี่ภาษาอะไรล่ะ', speechMetadata: { speaker: 'Flash', style: 'confused' } },
        { text: 'ภาษาใจครับพี่', speechMetadata: { speaker: 'Lite', style: 'deadpan' } },
      ],
    },
  },
};
ขั้นที่ 3: รันเทียบทั้งสองรุ่น
สคริปต์เต็ม tts-bench.ts วนส่งสคริปต์เดียวกัน 3 แบบ (ไทยพูดคนเดียว, ไทย 2 เสียง, อังกฤษเป็นตัวควบคุม) ให้ทั้งสองรุ่น แล้วเซฟ WAV/MP3 พร้อมจับเวลาและค่าใช้จ่าย ผลรันจริงเมื่อ 26 ก.ย. 2026 ราว 23:15 น. (เวลาไทย):
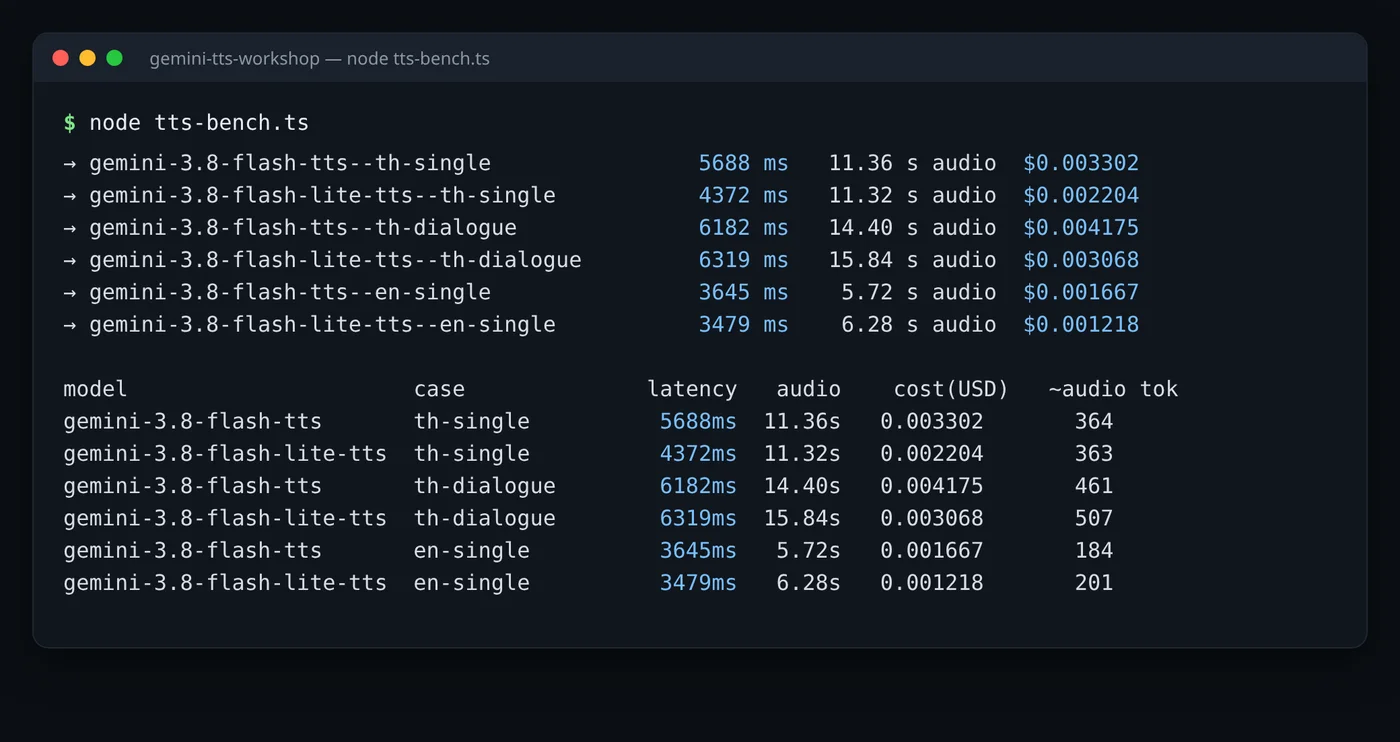
| เคส | รุ่น | เวลาตอบกลับ | ความยาวเสียง | ค่าใช้จ่ายจริง (USD) |
|---|---|---|---|---|
| ไทย พูดคนเดียว | Flash | 5,688 ms | 11.36 วิ | 0.003302 |
| ไทย พูดคนเดียว | Flash-Lite | 4,372 ms | 11.32 วิ | 0.002204 |
| ไทย 2 เสียง | Flash | 6,182 ms | 14.40 วิ | 0.004175 |
| ไทย 2 เสียง | Flash-Lite | 6,319 ms | 15.84 วิ | 0.003068 |
| อังกฤษ | Flash | 3,645 ms | 5.72 วิ | 0.001667 |
| อังกฤษ | Flash-Lite | 3,479 ms | 6.28 วิ | 0.001218 |
ผมยิงเคสไทยพูดคนเดียวซ้ำอีก 3 รอบ: Flash 5.62 / 5.00 / 5.32 วิ, Flash-Lite 4.85 / 4.10 / 4.39 วิ รวมกับรอบแรกได้มัธยฐานราว 5.3 vs 4.4 วินาที เวลานี้รวมเครือข่ายจากเครื่องผมผ่าน Gateway และเป็นคำขอแบบรอจนเสร็จ (ไม่ใช่ streaming) จึงเป็นแค่ตัวเลขบอกทิศทาง ไม่ใช่ benchmark
ลองฟังเสียงจริงเทียบกัน (ไฟล์ MP3 จากการรันข้างบน):
Flash TTS — ไทย พูดคนเดียว
Flash-Lite TTS — ไทย พูดคนเดียว
Flash TTS — ไทย 2 เสียง
Flash-Lite TTS — ไทย 2 เสียง
ดูคลิปผลลัพธ์ 10 วินาที
แมวเดินบนเปียโน พากย์โดย Flash กับ Flash-Lite TTS — คลิปโดย cottonbro studio / Pexels
ขั้นที่ 4: เช็กว่าฟังรู้เรื่องไหม ด้วยการถอดเสียงกลับ
หูคนเดียวตัดสินยาก ผมเลยส่งไฟล์เสียงทุกไฟล์ให้ google/gemini-3.5-transcribe ถอดกลับเป็นข้อความ (สคริปต์ transcribe-check.py) ผลคือข้อความไทยกลับมาเกือบตรงบททั้งสองรุ่น รวมถึง “ก๋วยเตี๋ยวเรือ”, “50 บาท” และ “Kubernetes”
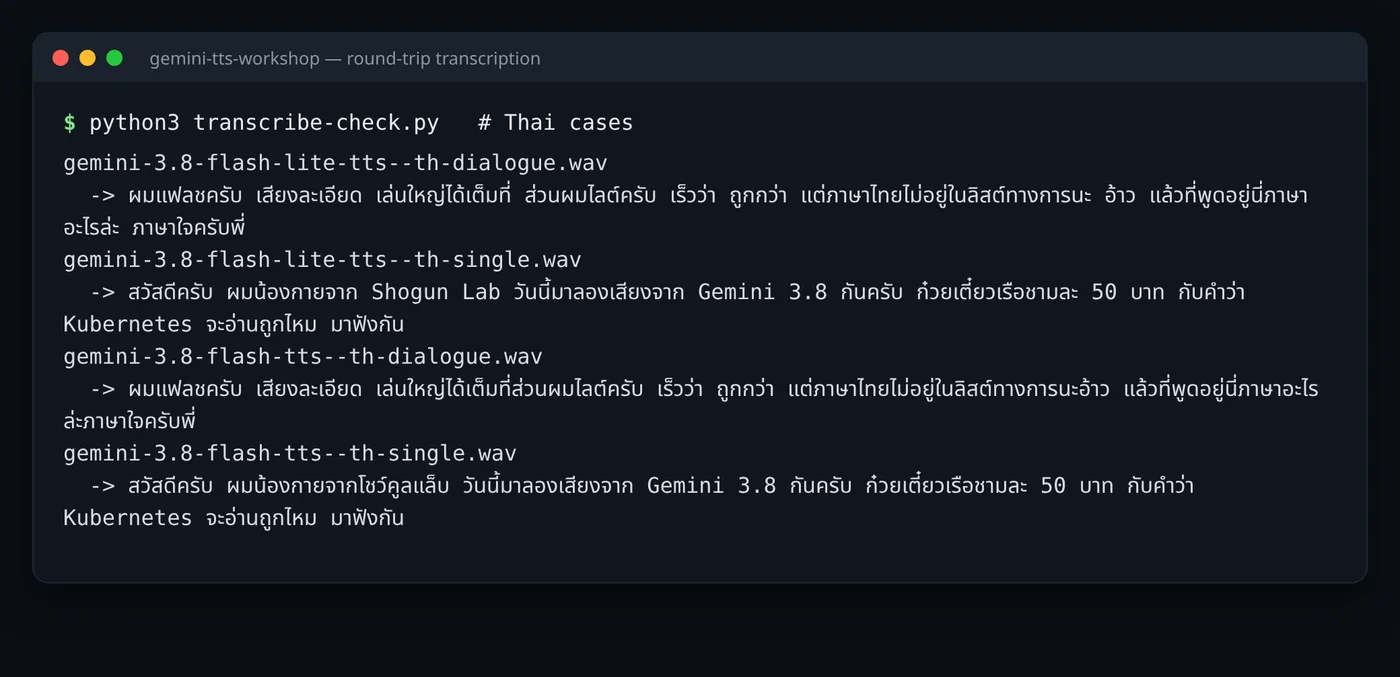
จุดที่พลาดเหมือนกันทั้งคู่คือชื่อแบรนด์ “Showkhun” — ตัวถอดเสียงได้ยินเป็น “โชว์คูลแล็บ”, “Shogun Lab” และ “Shokunin Lab” แปลว่าชื่อเฉพาะที่สะกดแบบไม่ปกติควรเขียนเป็นคำอ่านไทยในบท (เช่น “โชว์คุณ”) ถ้าอยากให้ออกเสียงนิ่ง
ข้อควรระวัง: การถอดเสียงได้ถูกแปลว่า “ฟังรู้เรื่อง” ไม่ได้แปลว่า “เสียงเป็นธรรมชาติ” ความรู้สึกของผมเองตอนฟังคือ Flash ใส่อารมณ์ตาม style ได้ชัดกว่า ส่วน Flash-Lite ราบกว่านิดหน่อย — อันนี้เป็นความเห็นส่วนตัว ลองฟังไฟล์ข้างบนแล้วตัดสินเองครับ
ขั้นที่ 5: คิดค่าใช้จ่ายล่วงหน้า
โค้ดนี้รันออฟไลน์ได้ ใช้ราคาจากหน้า pricing และอัตราที่ผมวัดได้จริงจาก Gateway (ประมาณ 0.29 และ 0.19 เซนต์ต่อเสียง 10 วินาที ในเคสไทย):
// ค่าใช้จ่ายที่วัดได้จริงต่อเสียง 10 วินาที (เคสไทยพูดคนเดียว, 26 ก.ย. 2026)
const measuredUsdPer10s = {
  flash: (0.003302 / 11.36) * 10,
  flashLite: (0.002204 / 11.32) * 10,
};

function monthlyCost(minutesPerMonth: number, usdPer10s: number): number {
  return (minutesPerMonth * 60 / 10) * usdPer10s;
}

for (const minutes of [10, 100, 1000]) {
  const f = monthlyCost(minutes, measuredUsdPer10s.flash);
  const l = monthlyCost(minutes, measuredUsdPer10s.flashLite);
  console.log(`${minutes} นาที/เดือน -> Flash $${f.toFixed(2)} | Flash-Lite $${l.toFixed(2)}`);
}
ผลที่ได้คือ 10 นาทีต่อเดือนราว $0.17 vs $0.12, 100 นาทีราว $1.74 vs $1.17 และ 1,000 นาทีราว $17.44 vs $11.68 (ราคาช่วงถึงสิ้นปี 2026 เท่านั้น ปีหน้าคูณสอง)
จุดที่ยังไม่ชัด และแหล่งข้อมูลพูดไม่ตรงกัน
- ภาษาไทยบน Flash-Lite: ตารางในเอกสาร Google บอกว่าไม่รองรับ แต่ผลจริงของผมพูดได้และถอดกลับได้ครบ ผมมองว่าอย่าอ่านผลนี้ว่า “รองรับแล้ว” — มันคือการทำงานนอกขอบเขตที่ Google รับรอง ซึ่งอาจเปลี่ยนเมื่อไหร่ก็ได้ บทความของ Picsart ก็ระบุตรงกันว่าไทยเป็นหนึ่งใน 29 ภาษาที่มีเฉพาะใน Flash
- จำนวนเสียง: Google Blog พูดถึง “2,000+ เสียง” ส่วนเอกสาร TTS เขียนว่า Extended Voice Library มี “หลายร้อย” เสียงนอกเหนือจาก 30 เสียงหลัก
- อัตราโทเคนต่อวินาที: หน้า pricing แปลงราคาเป็น “$0.00225 ต่อเสียง 10 วินาที” สำหรับ Flash (ประมาณ 25 โทเคนต่อวินาที) แต่บิลจริงที่ผมได้จาก Gateway ในเคสไทยตกราว $0.0029 ต่อ 10 วินาที สูงกว่าราว 29% ผมยังไม่รู้สาเหตุ — อาจเป็นวิธีนับโทเคนเสียงหรือช่วงเงียบในไฟล์ ให้ถือตัวเลขในบิลของคุณเป็นหลัก
- Rate limit ของ free tier: หน้า pricing บอกว่า Standard มี free tier แต่ผมยังไม่ได้ตรวจตัวเลขโควตาต่อนาที/ต่อวันของสองรุ่นนี้ ให้เช็กในหน้า rate limits ของ AI Studio ของบัญชีคุณเอง
- ผลทดสอบคุณภาพ ที่ยกมาเป็นตัวเลขที่ Google นำเสนอเอง ยังไม่เห็นการทดสอบอิสระที่วัดภาษาไทยโดยตรง
แล้วเราควรทำอะไร
- คนทำคอนเทนต์ไทย (คลิป/พอดแคสต์/หนังสือเสียง): เริ่มที่ Flash TTS เพราะเป็นตัวเดียวที่รับรองภาษาไทย และใส่อารมณ์ได้ดีกว่า คลิปสั้นยาวไม่กี่สิบวินาทีมีค่าเสียงไม่ถึง 1 เซนต์ดอลลาร์
- ทีมที่ทำ voice agent หรือ read-aloud ปริมาณมาก: ถ้าภาษาหลักอยู่ในลิสต์ของ Flash-Lite (อังกฤษ, ญี่ปุ่น, เวียดนาม ฯลฯ) ใช้ Flash-Lite ประหยัดได้ราว 1 ใน 3 ถ้าเป็นภาษาไทย ให้ใช้ Flash เป็นหลัก และวางแผนงบสำหรับราคาที่ขึ้นเท่าตัวในปี 2027
- นักพัฒนาที่ย้ายจาก 3.1 preview: ย้ายคำกำกับการพูดไปไว้ใน
styleใส่speakerทุกประโยคในบทสนทนา และเลิกห่อ WAV header เอง - ทุกคน: ใช้ Batch/Flex ถ้าไม่ต้องการผลทันที (ครึ่งราคา) และอย่าลืมบอกผู้ชมว่าเป็นเสียง AI
ผมมองว่าจุดเปลี่ยนของรุ่นนี้ไม่ใช่แค่เสียงดีขึ้น แต่คือ “ราคาเสียงที่ใส่อารมณ์ได้” ถูกลงจนคนทำคลิปคนเดียวก็จ้างนักพากย์ AI ได้ทุกวัน สิ่งที่ต้องจับตาต่อคือ Google จะเพิ่มภาษาไทยให้ Flash-Lite เมื่อไหร่ และราคาปี 2027 จะกระทบงานปริมาณมากแค่ไหน — คุณจะให้ AI พากย์งานแบบไหนก่อนครับ?
Recap
- ชื่อที่ถูก:
gemini-3.8-flash-ttsและgemini-3.8-flash-lite-tts(GA, 23 ก.ย. 2026) - ภาษาไทยอยู่ในลิสต์ทางการของ Flash เท่านั้น
- Output เสียง $9 vs $6 ต่อล้านโทเคนถึงสิ้นปี 2026 แล้วขึ้นเท่าตัว
- สไตล์การพูดใส่ใน
style/instructionsไม่ใช่ในข้อความ - ผลจริงของผม: Flash-Lite ถูกกว่า ~33% เร็วกว่า ~1 วินาที ถอดเสียงไทยกลับได้ทั้งคู่
- ชื่อเฉพาะแปลกๆ เขียนเป็นคำอ่านไทยในบท