LeetCode 217 Contains Duplicate: เลือก set, sort หรือ brute force
โจทย์ให้ลำดับจำนวนเต็มแล้วถามว่ามีค่าใดปรากฏมากกว่าหนึ่งครั้งหรือไม่ครับ สิ่งที่ต้องตัดสินไม่ใช่เพียงให้ผ่าน แต่เลือกวิธีตามขนาดข้อมูล memory และสิทธิ์แก้ input
WHY: early exit กับ memory เป็น trade-off หลัก
วิธี brute force เปรียบเทียบทุกคู่ ใช้ O(1) memory แต่ O(n²) time การ sort สำเนาใช้ O(n log n) time แล้วเทียบเพื่อนบ้าน ส่วน hash set ใช้เวลาเฉลี่ย O(n) และหยุดทันทีเมื่อเจอซ้ำ แต่ใช้ O(n) memory
ถ้า input เป็น stream set เป็นตัวเลือกเดียวในสามวิธีที่อ่านทีละค่าและ early exit ได้โดยไม่เก็บลำดับทั้งหมด แม้ยังต้องเก็บค่าที่ไม่ซ้ำจนถึงจุดนั้น
HOW: ให้ implementation แสดงสัญญาเรื่อง mutation
import unittest


def has_duplicate_brute(values):
    return any(values[i] == values[j]
               for i in range(len(values))
               for j in range(i + 1, len(values)))


def has_duplicate_sorted(values):
    ordered = sorted(values)
    return any(left == right for left, right in zip(ordered, ordered[1:]))


def has_duplicate_set(values):
    seen = set()
    for value in values:
        if value in seen:
            return True
        seen.add(value)
    return False


class DuplicateTests(unittest.TestCase):
    def test_all_implementations(self):
        cases = [([], False), ([1], False), ([1, 2, 1], True), ([-1, 0, -1], True)]
        for function in (has_duplicate_brute, has_duplicate_sorted, has_duplicate_set):
            for values, expected in cases:
                with self.subTest(function=function.__name__, values=values):
                    self.assertEqual(function(values), expected)

    def test_sorted_version_does_not_mutate_input(self):
        values = [3, 1, 2]
        has_duplicate_sorted(values)
        self.assertEqual(values, [3, 1, 2])


if __name__ == "__main__":
    unittest.main()
ตารางตัดสินใจ
| เงื่อนไข | วิธีที่เหมาะ | เวลา | memory | หมายเหตุ |
|---|---|---|---|---|
| default ทั่วไป | set | เฉลี่ย O(n) | O(n) | early exit และอ่านง่าย |
| memory จำกัดและแก้ input ได้ | in-place sort | O(n log n) | ตาม sort | ทำลำดับเดิม |
| input เล็กมาก | brute force | O(n²) | O(1) | ง่ายแต่โตไม่ดี |
| streaming | set | เฉลี่ย O(n) | O(u) | u คือค่าที่เห็นไม่ซ้ำ |
best default ภายใต้ constraint ทั่วไปคือ set เพราะ intent ชัดและ latency คาดหวังดี หาก memory เป็นข้อจำกัดจริงและ input อยู่ใน list ให้ sort in place แทนตัวอย่างที่ copy แต่ต้องประกาศ mutation ใน contract
edge cases คือ list ว่าง ค่าเดียว ค่าลบ ค่าซ้ำติดกันหรือห่างกัน และชนิดที่ hash ไม่ได้ หากโจทย์ขยายเป็น object ต้องนิยาม equality/key ให้ชัด
รู้จักผู้เข้าแข่งขัน
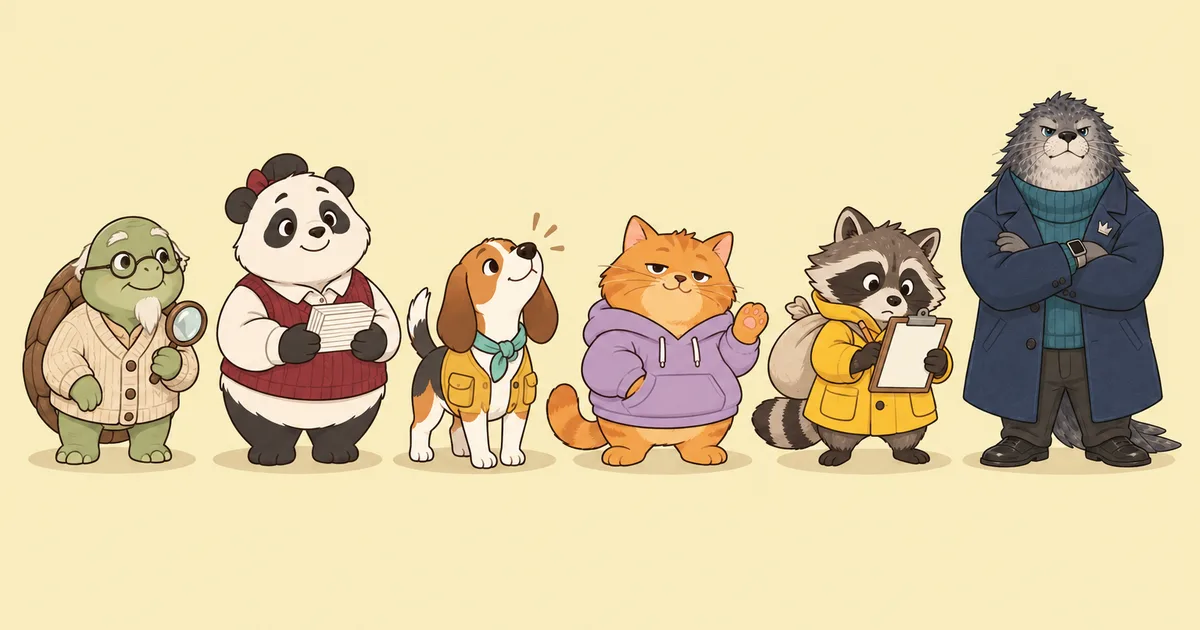
สามวิธีข้างบนเป็นตัวหลักครับ แต่ในโค้ด Python จริงยังมีอีกสองแบบที่ผมเห็นบ่อยมาก คือบรรทัดเดียว len(set(nums)) != len(nums) กับการนับด้วย collections.Counter รอบนี้ผมเลยให้ทั้ง 5 วิธีเป็นตัวละคร เถียงกันว่าใครเร็วสุด แล้วให้ benchmark ที่วัดจริงตัดสิน ปิดท้ายด้วยบารอนสรุป
| ตัวละคร | วิธี | นิสัย |
|---|---|---|
| ปู่เต่า เต่าแก่ใส่แว่นกลม เคราขาว คาร์ดิแกนไหมพรมสีครีม ถือแว่นขยาย | เทียบทุกคู่ (brute force) | ช้าแต่ละเอียด ไม่ยอมข้ามสักคู่ |
| ป้าแพนด้า แพนด้าบรรณารักษ์ เสื้อกั๊กสีแดงเลือดหมู ถือปึกบัตรรายการ | sort สำเนาแล้วดูตัวข้างๆ | ต้องจัดชั้นให้เรียงก่อนถึงจะทำอย่างอื่น |
| บีเกิล หมาบีเกิลสามสี เสื้อกั๊กสีเหลืองมัสตาร์ด ผ้าพันคอสีมิ้นต์ | set + หยุดทันทีที่เจอซ้ำ | จมูกไว ดมทีละตัว เจอกลิ่นซ้ำปุ๊บเห่าเลย |
| เหมียว แมวส้มตัวอ้วนใส่ฮู้ดสีลาเวนเดอร์ ตาปรือ | len(set(nums)) != len(nums) | ขี้เกียจ ขอบรรทัดเดียวพอ |
| แรคคูน แรคคูนใส่เสื้อกันฝนสีเหลือง ถือคลิปบอร์ด สะพายถุงผ้า | Counter นับทุกตัว | ละเอียดจนจุกจิก ต้องนับให้ครบก่อนตอบ |
| บารอน สิงโตทะเลใส่โค้ทกรมท่า เสื้อคอเต่าสีเทาอมเขียว | กรรมการ | เข้มแต่แฟร์ ฟังตัวเลขมากกว่าเสียงดัง |
เถียงกันทีละยก
ยกที่ 1: ปู่เต่า เทียบทุกคู่
ปู่เต่า: “ปู่เทียบทีละคู่ ให้ครบทุกคู่ ช้าหน่อย แต่ไม่พลาดสักคู่”
ป้าแพนด้า: “ปู่คะ หมื่นตัวมันเกือบห้าสิบล้านคู่นะคะ”
ปู่เต่า: “ปู่ไม่รีบ”
list 10,000 ตัวมีคู่ให้เทียบ 10,000 × 9,999 ÷ 2 = 49,995,000 คู่ เวลา O(n²) แต่ไม่ใช้ memory เพิ่มเลย จุดแข็งจริงของปู่เต่าคือโค้ดตรงไปตรงมาจนแทบเขียนผิดไม่ได้ ผมจึงใช้เป็นคำตอบอ้างอิง (oracle) ใน test ด้านล่าง
ยกที่ 2: ป้าแพนด้า เรียงก่อนค่อยดู
ป้าแพนด้า: “เรียงก่อนสิคะ! ตัวซ้ำจะมาอยู่ติดกันเอง แล้วดูแค่ตัวข้างๆ”
บีเกิล: “แต่ป้าต้องเรียงให้ครบทั้งชั้นก่อนถึงจะเริ่มดูได้นะครับ ต่อให้ตัวซ้ำอยู่หน้าสุดก็ตาม”
sorted() คืน list ใหม่ input เดิมไม่เปลี่ยน เวลา O(n log n) แล้วไล่ดูเพื่อนบ้านอีกรอบ ถ้าใช้ nums.sort() แทนจะประหยัด memory ได้ แต่ลำดับเดิมของผู้เรียกหายไป ตรงกับที่ผมเตือนไว้ในตารางตัดสินใจข้างบน
ยกที่ 3: บีเกิล ดมทีละตัว
บีเกิล: “ผมดมทีละตัว จำกลิ่นใส่ set ไว้ เจอกลิ่นซ้ำปุ๊บ เห่าเลย!”
เหมียว: “เขียนตั้งหกบรรทัด เหนื่อยแทน”
นี่คือ has_duplicate_set ข้างบน การเช็ก x in seen ใช้เวลาเฉลี่ย O(1) ตาม Python wiki TimeComplexity ทั้งลูปจึงเฉลี่ย O(n) และเป็นวิธีเดียวในห้าวิธีที่ทั้งหยุดทันทีที่เจอซ้ำ และอ่านข้อมูลทีละตัวได้โดยไม่ต้องรู้ความยาวทั้งหมดก่อน
ยกที่ 4: เหมียว บรรทัดเดียวพอ
เหมียว: “บรรทัดเดียวพอ แปลงเป็น set แล้วดูว่าความยาวหดไหม หดแปลว่ามีตัวซ้ำโดนกลืนไป”
บีเกิล: “แต่เหมียวต้องสร้าง set ให้ครบทุกตัวก่อนถึงจะรู้คำตอบนะ”
เหมียว: “ก็สร้างเร็วนี่”
len(set(nums)) != len(nums) อ่านง่ายที่สุดในห้าวิธี เวลาเฉลี่ย O(n) memory O(n) แต่ไม่มี early exit และใช้ได้เฉพาะข้อมูลที่อยู่ครบใน list แล้ว เพราะต้องรู้ len(nums)
ยกที่ 5: แรคคูน นับให้ครบ
แรคคูน: “นับทุกตัวด้วย Counter ตัวไหนเกิน 1 คือซ้ำ! ได้รู้ด้วยว่าซ้ำกี่ครั้ง”
ปู่เต่า: “โจทย์ถามแค่ว่ามีไหม ไม่ได้ถามว่ากี่ครั้งนะหลาน”
collections.Counter เป็น dict ที่นับว่าแต่ละค่าเจอกี่ครั้ง แรคคูนต้องนับครบทุกตัวก่อน แล้วไล่ดูจำนวนอีกรอบ เวลาเฉลี่ย O(n) memory O(n) ทำงานเกินที่โจทย์ถาม แต่ถ้าโจทย์เปลี่ยนเป็น “ค่าไหนซ้ำกี่ครั้ง” แรคคูนตอบได้ทันที
โค้ดทั้ง 5 วิธีพร้อม test
บล็อกนี้รันจริงตอนตรวจบทความ ทดสอบทุกวิธีกับตัวอย่างโจทย์และ edge cases เช็กว่าไม่มีวิธีไหนแก้ list ของผู้เรียก สุ่มอีก 300 ชุดเทียบกับปู่เต่า และเช็ก input ชุดเดียวกับที่ใช้วัด benchmark
import random
import unittest
from collections import Counter


def dup_brute(nums):
    n = len(nums)
    for i in range(n):
        for j in range(i + 1, n):
            if nums[i] == nums[j]:
                return True
    return False


def dup_sorted(nums):
    ordered = sorted(nums)
    for i in range(len(ordered) - 1):
        if ordered[i] == ordered[i + 1]:
            return True
    return False


def dup_set_scan(nums):
    seen = set()
    for x in nums:
        if x in seen:
            return True
        seen.add(x)
    return False


def dup_len_set(nums):
    return len(set(nums)) != len(nums)


def dup_counter(nums):
    return any(c > 1 for c in Counter(nums).values())


ALL = [dup_brute, dup_sorted, dup_set_scan, dup_len_set, dup_counter]


def benchmark_inputs():
    rng = random.Random(217)
    unique = rng.sample(range(-10**9, 10**9), 10_000)
    early = list(unique)
    early[5] = early[3]
    return unique, early


class TestContainsDuplicate(unittest.TestCase):
    def check(self, nums, expected):
        for fn in ALL:
            with self.subTest(fn=fn.__name__, nums=nums[:8]):
                data = list(nums)
                self.assertIs(fn(data), expected)
                self.assertEqual(data, nums)  # the caller's list is unchanged

    def test_examples(self):
        self.check([1, 2, 3, 1], True)
        self.check([1, 2, 3, 4], False)
        self.check([1, 1, 1, 3, 3, 4, 3, 2, 4, 2], True)

    def test_edges(self):
        self.check([], False)
        self.check([7], False)
        self.check([5, 5], True)
        self.check([-1, 0, -1], True)

    def test_random_against_brute(self):
        rng = random.Random(217)
        for _ in range(300):
            nums = [rng.randint(-20, 20) for _ in range(rng.randint(0, 30))]
            self.check(nums, dup_brute(list(nums)))

    def test_benchmark_inputs(self):
        unique, early = benchmark_inputs()
        self.assertEqual(len(set(unique)), 10_000)
        for fn in ALL[1:]:
            self.assertIs(fn(unique), False)
            self.assertIs(fn(early), True)
        # brute force over all 10,000 items takes about a second, so check a prefix
        self.assertIs(dup_brute(unique[:500]), False)
        self.assertIs(dup_brute(early), True)


if __name__ == "__main__":
    unittest.main()
benchmark ตัดสิน
บารอน: “พอแล้ว เถียงกันไปก็ไม่จบ ใครเร็วจริงไปวัดมาให้ดู”
วัดบน Mac ชิป Apple M5 Pro ด้วย Python 3.15.0 (CPython) ใช้ timeit input สร้างด้วย random.Random(217) สุ่มจำนวนเต็มไม่ซ้ำ 10,000 ตัวในช่วง ±1,000 ล้าน แล้ววัดสองเคส
- เคส A ไม่มีตัวซ้ำเลย ทุกวิธีต้องดูครบทุกตัวถึงจะตอบ
Falseได้ เป็นเคสที่แย่สุดของ early exit - เคส B ตัวซ้ำอยู่ต้นลิสต์ เอาค่าที่ตำแหน่ง index 3 ไปทับตำแหน่ง index 5 (ตัวที่ 6) ได้ list เดิมที่มีคู่ซ้ำอยู่ใกล้หัว
แต่ละวิธีเรียก 200 ครั้งต่อรอบ ทำ 5 รอบ แล้วเอารอบที่เร็วที่สุดหารด้วย 200 ยกเว้นปู่เต่าในเคส A ที่ครั้งเดียวใช้เกือบ 0.7 วินาที เลยวัด 3 รอบ รอบละครั้ง ทุกวิธีไม่แก้ input (test ข้างบนยืนยันแล้ว) จึงใช้ list เดิมซ้ำได้โดยไม่ต้องทำสำเนาทุกครั้ง
โค้ดด้านล่างเป็นโค้ดบางส่วน ไม่ได้รันตอนตรวจบทความ ใช้ฟังก์ชันจากบล็อกด้านบนที่เซฟเป็นไฟล์ solutions.py
import timeit
from solutions import ALL, benchmark_inputs, dup_brute

unique, early = benchmark_inputs()
for case, data in [("A: no duplicate", unique), ("B: duplicate at index 5", early)]:
    for fn in ALL:
        number, repeat = (1, 3) if fn is dup_brute and data is unique else (200, 5)
        best = min(timeit.repeat(lambda: fn(data), number=number, repeat=repeat)) / number
        print(f"{case:24s} {fn.__name__:14s} {best * 1e6:12,.2f} µs")
ms คือมิลลิวินาที (หนึ่งในพันวินาที) µs คือไมโครวินาที (หนึ่งในล้านวินาที) ครับ
| ตัวละคร (วิธี) | เคส A: 10,000 ตัว ไม่มีซ้ำ | เคส B: ซ้ำที่ตัวที่ 6 |
|---|---|---|
| ปู่เต่า (เทียบทุกคู่) | 684.69 ms | 392.8 µs |
| ป้าแพนด้า (sort แล้วดูข้างๆ) | 0.587 ms | 483.3 µs |
| บีเกิล (set + หยุดทันที) | 0.227 ms | 0.16 µs |
เหมียว (len(set)) | 0.085 ms | 93.1 µs |
แรคคูน (Counter) | 0.296 ms | 195.6 µs |
ผมรันชุดเดียวกันซ้ำอีกรอบ ตัวเลขขยับไปไม่กี่เปอร์เซ็นต์ แต่อันดับเหมือนเดิมทั้งสองเคส ตัวเลขทั้งหมดมาจากเครื่องเดียว เครื่องอื่นหรือ Python เวอร์ชันอื่นจะได้ค่าไม่เท่านี้ สิ่งที่อ่านได้จากตารางคือ
- เคส A ปู่เต่าช้ากว่าเหมียวราว 8,000 เท่า (684.69 ÷ 0.085) นี่คือราคาของการเทียบเกือบ 50 ล้านคู่
- เหมียวเร็วกว่าบีเกิลราว 2.7 เท่า ทั้งที่ Big-O เท่ากัน เพราะ
set(nums)วนสร้าง set ในโค้ด C ทั้งก้อน ส่วนบีเกิลวนforทีละตัวใน Python และทำinกับaddแยกกันสองครั้ง - แรคคูนช้ากว่าเหมียวราว 3.5 เท่า เพราะต้องนับทุกตัวลง dict แล้วไล่ดูจำนวนอีกรอบ ส่วนป้าแพนด้าช้ากว่าเหมียวราว 7 เท่าตามต้นทุน sort
- เคส B ผลพลิก บีเกิลหยุดตั้งแต่ตัวที่ 6 ใช้แค่ 0.16 µs เร็วกว่าเหมียว (93.1 µs) เกือบ 600 เท่า เพราะเหมียวกับแรคคูนยังต้องสร้าง set หรือนับให้ครบหมื่นตัวทุกครั้ง
- ปู่เต่าเจอคู่ซ้ำ (index 3 กับ 5) แต่ยังใช้ 392.8 µs เพราะลูปนอกต้องเอาสามตัวแรกไปเทียบกับทุกตัวที่เหลือก่อน กว่าจะเจอคู่นี้ก็เทียบไป 29,996 ครั้ง ส่วนป้าแพนด้าช้าสุดในเคสนี้ เพราะต้อง sort ครบทั้งลิสต์ก่อนเสมอ
บีเกิล: “เห็นไหมครับ ตัวซ้ำอยู่ต้นลิสต์เมื่อไหร่ ผมเห่าก่อนใครเลย”
เหมียว: “แต่ลิสต์ไม่มีตัวซ้ำ ฉันก็ยังเร็วสุดอยู่ดี”
ปู่เต่า: “ปู่ขอนับคู่ต่ออีกสักพักนะ”
บารอนสรุป
บารอน: “ทุกคนตอบถูกหมด แต่ข้อนี้ตัดสินว่า ใช้ set!
ถ้าข้อมูลมาครบก้อนเป็น list อยู่แล้ว และส่วนใหญ่ไม่มีตัวซ้ำ ใช้แบบเหมียว บรรทัดเดียว เร็วสุดในการวัด ถ้าข้อมูลไหลมาทีละตัว หรือตัวซ้ำมักโผล่เร็ว ใช้แบบบีเกิล หยุดได้ก่อนใคร
ปู่เต่าเก็บไว้เป็นตัวเทียบคำตอบใน test ป้าแพนด้าใช้ตอน memory จำกัดจริงและยอม sort ใน list เดิม ส่วนแรคคูนเก็บไว้ตอนโจทย์ถามว่าซ้ำกี่ครั้ง”
| วิธี | เวลา | memory เพิ่ม | หยุดเมื่อเจอซ้ำ | ใช้เมื่อ |
|---|---|---|---|---|
| ปู่เต่า (เทียบทุกคู่) | O(n²) | O(1) | ✅ แต่ตัวแรกๆ ต้องเทียบครบแถวก่อน | oracle ใน test หรือ input เล็กมาก |
| ป้าแพนด้า (sort สำเนา) | O(n log n) | O(n) (sort ใน list เดิมประหยัดกว่า) | ❌ ต้อง sort ครบก่อน | memory จำกัดและยอมแก้ list |
| บีเกิล (set + หยุดทันที) | เฉลี่ย O(n) | O(u) | ✅ ทันที | stream หรือตัวซ้ำมักเจอเร็ว |
เหมียว (len(set)) | เฉลี่ย O(n) | O(n) | ❌ | list ครบก้อน ต้องการโค้ดสั้นสุด |
แรคคูน (Counter) | เฉลี่ย O(n) | O(n) | ❌ | ต้องการรู้ว่าซ้ำกี่ครั้ง |
u คือจำนวนค่าที่ไม่ซ้ำที่เห็นก่อนเจอตัวซ้ำ เหมือนในตารางตัดสินใจข้างบนครับ
Recap
- เลือก set เป็น default เมื่อมี memory พอ
- sort เมื่อต้องลด auxiliary memory และยอมเสียลำดับได้
- brute force เหมาะเฉพาะ input เล็กหรือใช้เป็น oracle ใน test
- ทดสอบ non-mutation หาก implementation สัญญาว่าจะรักษา input
- streaming ยังต้องจำค่าที่ไม่ซ้ำทั้งหมดจนกว่าจะเจอซ้ำ
- วัดจริง 10,000 ตัวที่ไม่มีซ้ำ:
len(set(nums)) != len(nums)0.085 ms เร็วสุด เทียบทุกคู่ 684.69 ms - ตัวซ้ำอยู่ต้นลิสต์: set + หยุดทันที 0.16 µs ชนะทุกวิธี
- Big-O เท่ากันไม่ได้แปลว่าเร็วเท่ากัน ลูปที่ทำใน C ของ Python ชนะลูป
forที่เขียนเอง
ลอง benchmark จุด crossover บนข้อมูลจริงก่อนแทน set ด้วยวิธีที่ซับซ้อนกว่าครับ