NVIDIA Open Agent Safety Platform: ย้ายตัวเฝ้า agent ออกนอก sandbox
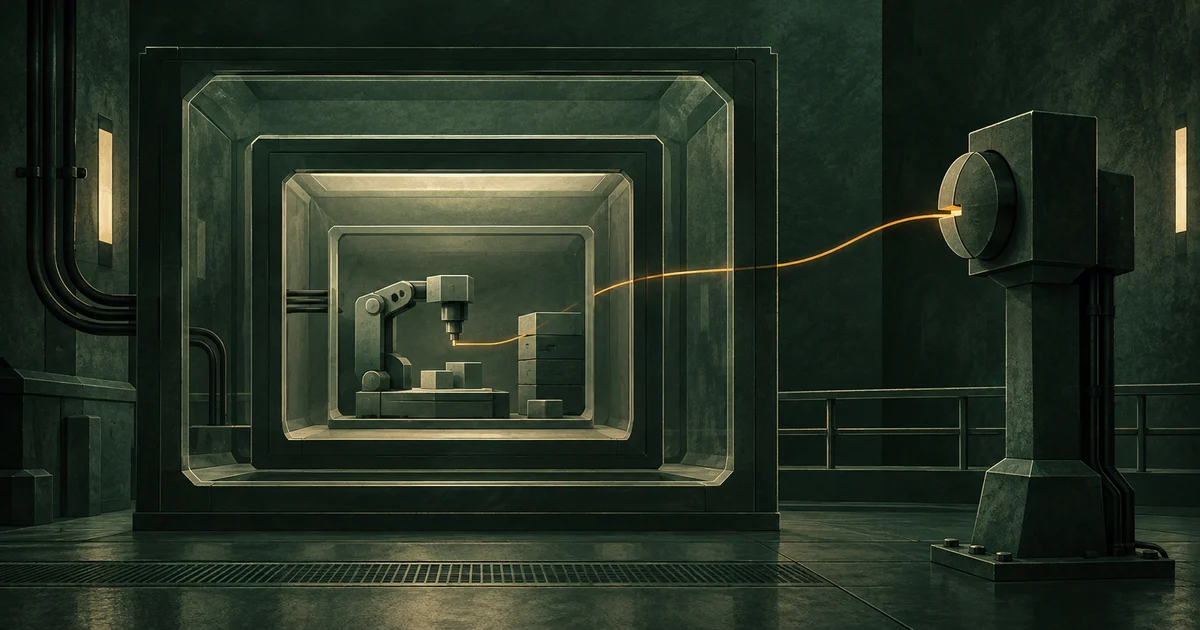
NVIDIA เปิด Open Agent Safety Platform ชุดแนวทางและองค์ประกอบสำหรับคุม AI agent ตั้งแต่ทดสอบถึงใช้งานจริง ใจกลางของเรื่องไม่ใช่ “AI ตรวจ AI” เพียงอย่างเดียว แต่คือการแยกตัวบังคับ policy ออกจาก process ที่ agent ควบคุมให้มากที่สุด เพราะถ้าผู้เฝ้าอยู่ในห้องเดียวกับผู้ทำงาน เมื่อ agent หรือ dependency ถูกยึด ผู้เฝ้าอาจถูกปิดพร้อมกันได้ครับ
ผมตรวจ ข่าวประชาสัมพันธ์ของ NVIDIA, บทความเทคนิคของ NVIDIA และรายงานอิสระสองชิ้นของ AP ทั้ง ภาพรวมแพลตฟอร์ม กับ คำอธิบาย OpenShell/Sentry ณ 29 กันยายน 2026 ตัวเลขประสิทธิภาพและการตอบสนองระดับมิลลิวินาทีเป็น claim ของผู้ผลิต ยังต้องวัดกับระบบจริง
สรุป 30 วินาที
- Open Agent Safety Platform รวม runtime isolation, policy, evaluation และกลไกเฝ้าระวังนอก environment ของ agent
- OpenShell วาง agent และเครื่องมือใน runtime ที่กำหนด filesystem, network และคำสั่งได้ละเอียดขึ้น
- Agent Toolkit ช่วยทดสอบและกำหนดกติกาก่อน deploy ส่วน Sentry เป็นแนวทางให้ DPU หรือองค์ประกอบที่แยกจาก host เฝ้าพฤติกรรมและกักระบบเมื่อผิดปกติ
- จุดขายคือ out-of-band monitoring: ตัวเฝ้าไม่ได้พึ่ง process เดียวกับ agent จึงยังทำงานได้ในบางกรณีที่ host ถูกยึด
- แนวคิดมีประโยชน์ แต่เส้นทางฮาร์ดแวร์ไม่ได้ใช้ได้กับทุกเครื่อง ทุก cloud หรือทุก budget และไม่แทน identity, secret management, code review หรือ incident response
ทำไมเรื่องนี้เกี่ยวกับคุณ
agent ต่างจาก chatbot ตรงที่มี “มือ” ผ่าน shell, browser, database, cloud API และ MCP tool ความผิดพลาดหนึ่งครั้งจึงเปลี่ยนไฟล์ ส่งข้อความ หรือเปิดทรัพยากรจริงได้ ระบบทั่วไปมักฝาก policy ไว้ใน application เดียวกับ agent หาก prompt injection ทำให้ application เรียก tool ผิด หรือช่องโหว่ใน dependency ยึด process ได้ กติกาที่อยู่ใน process นั้นก็อาจถูกข้าม
ทีมเล็กอาจคิดว่า DPU เป็นเรื่อง data center ใหญ่ แต่หลักคิดแยก enforcement plane ใช้ได้แม้ไม่มีฮาร์ดแวร์ NVIDIA: รัน worker ใน container/VM แยก, ให้ broker ภายนอกตรวจ capability, จำกัด egress, ใช้ short-lived credential และเก็บ audit log อีกระบบหนึ่ง ข่าวนี้จึงมีค่าตรงสถาปัตยกรรม มากกว่าการบอกให้ทุกคนซื้ออุปกรณ์ชุดเดียว
สำหรับองค์กรที่มี agent หลายตัว ความเสี่ยงไม่ใช่เฉพาะ agent หนึ่งตัวหลุด แต่รวมการส่งต่อบริบทและ credential ระหว่าง agent ถ้าตัวหนึ่งรับข้อความจากเว็บแล้วอีกตัวถือสิทธิ์ production เส้นทาง trust อาจยาวเกินที่ทีมมองเห็น แพลตฟอร์มนี้ผลักให้ inventory tool, policy และ session เป็นของที่ตรวจสอบได้ ไม่ใช่ซ่อนอยู่ใน prompt
ทำงานยังไง
นึกถึงโรงแรมที่พนักงานถือคีย์การ์ด พนักงานไม่ได้ถือกุญแจแม่ทุกห้อง แต่ขอผ่านระบบกลางที่รู้ว่าใครเข้าห้องไหน เวลาใด OpenShell ทำหน้าที่คล้ายพื้นที่ทำงานที่ประตูกับทางออกมี policy: agent อาจอ่านเฉพาะ workspace, เขียนเฉพาะโฟลเดอร์ชั่วคราว และออก network ได้เฉพาะปลายทางที่กำหนด
ชั้นถัดมาคือ evaluation และ policy tooling ก่อนปล่อย agent ทีมต้องทดลอง prompt injection, tool misuse, การขอ secret, path traversal และผลลัพธ์ที่คลุมเครือ แล้วเปลี่ยนสิ่งที่พบเป็น policy ที่บังคับได้ การเขียนใน system prompt ว่า “ห้ามทำอันตราย” อย่างเดียวเหมือนติดป้ายห้ามเข้าห้องเก็บเงินแต่ไม่ล็อกประตู ข้อความช่วยสื่อเจตนา แต่ enforcement ต้องอยู่ต่ำกว่าตัวตัดสินใจ
Sentry เพิ่มตัวเฝ้า out-of-band บน DPU หรือ silicon path ที่แยกจาก CPU/OS หลัก แนวคิดคือดู network, workload signal และ policy violation จากข้างนอก เมื่อเห็น anomaly สามารถกัก workload โดยไม่ต้องขอความร่วมมือจาก process ที่อาจถูกยึด เปรียบเหมือน รปภ. อยู่ห้องควบคุมอีกอาคารและตัดประตูได้ ไม่ใช่นั่งโต๊ะเดียวกับคนที่ถูกตรวจ
NVIDIA ยังวางเส้นทางกับ Vera CPU สำหรับการแยกและตรวจในระดับระบบมากขึ้น แต่รายละเอียดการรองรับขึ้นกับ platform และ deployment ไม่ควรอ่านว่า software package เดียวทำให้เครื่องทั่วไปมีคุณสมบัติเท่ากันทั้งหมด การแยกด้วย hardware ให้ boundary เพิ่ม แต่ policy ที่ผิดก็ยังบังคับผิดได้อย่างรวดเร็ว
เรื่องเงินและผลกระทบ
ต้นทุนแรกคือ integration: ต้อง inventory tool, ทำ policy, แยก credential, ปรับ network และสร้าง test corpus งานนี้ไม่หายไปเพราะติดตั้ง runtime ใหม่ หากระบบมี agent สิบตัวแต่ใช้ tool ร่วมร้อยรายการ การจัด capability ให้เหมาะแต่ละ role อาจเป็นงาน governance ใหญ่ อย่างไรก็ตามต้นทุนนี้ช่วยเปิดสิ่งที่เคยซ่อนและลด blast radius เมื่อ incident เกิด
ต้นทุนฮาร์ดแวร์และ platform lock-in ต้องคิดแยก บางความสามารถของ Sentry ผูกกับ DPU/silicon path ของ NVIDIA องค์กรที่อยู่บน cloud หรือ hardware อื่นต้องถามว่ามี equivalent control ใด และ telemetry ส่งออกในรูปแบบมาตรฐานหรือไม่ ถ้าผูก policy กับอุปกรณ์รุ่นเดียวจนย้ายไม่ได้ ค่าใช้จ่ายระยะยาวอาจสูงกว่าค่า license ที่เห็นวันแรก
ด้าน performance ผู้ผลิตกล่าวถึงการตรวจและตอบสนองในระดับมิลลิวินาที แต่ latency จริงขึ้นกับ rule, traffic, model และ topology หาก policy engine กลายเป็นจุดคอขวด ทีมอาจเผลอปิด rule เพื่อให้ระบบเร็วขึ้น จึงต้องตั้ง SLO ของ enforcement และ capacity test เหมือนระบบ production อื่น ไม่ใช่เพิ่ม security หลังสุดแล้วหวังว่าจะฟรี
ข้อมูลที่ยังไม่ชัดและแหล่งที่ไม่ตรงกัน
NVIDIA อธิบายชุดนี้ว่าเป็น open platform และ reference สำหรับ ecosystem แต่คำว่า open มีหลายระดับ: source code, API, policy format, hardware interface และ certification อาจเปิดไม่เท่ากัน แหล่งที่ตรวจยังไม่ให้ matrix ครบว่าชิ้นใด production-ready, license ใด และรองรับ third-party hardware ลึกแค่ไหน จึงต้องดู repository และเอกสารของแต่ละ component ก่อน procurement
ข่าวประชาสัมพันธ์เน้นการกัก agent อย่างรวดเร็ว ขณะที่ AP ยกความเห็นนักวิชาการว่าทิศทางนี้เป็น “ก้าวที่ถูกทาง” แต่ยังมีโจทย์ยากเรื่องนิยามพฤติกรรมผิดปกติและ false positive นี่ไม่ใช่ข้อขัดแย้งเรื่องการมีผลิตภัณฑ์ แต่เป็นช่องว่างระหว่างความสามารถที่ผู้ผลิตตั้งเป้ากับหลักฐานภาคสนามอิสระที่ยังจำกัด
ยังไม่ชัดว่า policy ตรวจความหมายระดับงานได้ดีแค่ไหน ตัวอย่างเช่น agent โอนเงินให้บัญชีที่รูปแบบถูกต้องและปลายทางอยู่ allowlist แต่จำนวนเงินผิดหนึ่งหลัก network monitor อาจเห็น traffic ถูกกติกาทั้งหมด ต้องมี business rule และ human approval ชั้นบนร่วมด้วย
ไม่มีข้อมูลสาธารณะครบเกี่ยวกับราคาไทย, overhead ต่อ workload, retention ของ telemetry, SLA ของการ quarantine และวิธี forensic หลังเหตุในทุก deployment แหล่งของ NVIDIA อธิบายสถาปัตยกรรม ส่วน AP ให้บริบทอิสระ แต่ยังไม่มี benchmark ข้าม vendor ที่ทำซ้ำได้
ความเสี่ยงที่ยังต้องออกแบบเอง
Prompt injection ยังเข้ามาทางเว็บ เอกสาร issue หรืออีเมลได้ Runtime จำกัดผลกระทบแต่ไม่รู้เจตนาธุรกิจทั้งหมด Secret ที่ mount เข้า sandbox กว้างเกินไปยังถูกขโมยได้ และ output ที่ถูกต้องทางเทคนิคยังอาจเป็นการตัดสินใจผิด
Policy supply chain ก็เป็นจุดเสี่ยง หาก rule package, model monitor หรือ update channel ถูกยึด ตัวบังคับอาจอนุญาตสิ่งที่ไม่ควร ทีมต้องตรวจ signature, pin version, แยกคนอนุมัติ policy และมี rollback ที่ทดสอบแล้ว การย้าย enforcement ออกนอก agent ไม่ได้แปลว่า enforcement นั้นเชื่อถือได้โดยอัตโนมัติ
สุดท้าย out-of-band monitor อาจเห็นข้อมูลละเอียด เช่น command, path, endpoint หรือ payload ต้องกำหนด minimization, access control และ retention ไม่เช่นนั้นระบบที่สร้างเพื่อความปลอดภัยจะกลายเป็นคลังข้อมูลลับอีกก้อน
ควรทำอะไร
ทีมที่เริ่มทำ agent ให้เขียนแผนภาพ trust boundary ก่อนเลือก product ระบุข้อมูลเข้า, tool, credential, network destination, action ที่ย้อนกลับไม่ได้ และเจ้าของ approval จากนั้นทดลอง OpenShell หรือแนวคิดเดียวกันใน sandbox ที่ไม่มี production credential วัดว่า policy ใดบล็อกงานดีและ policy ใดสร้าง false positive
ทีม platform ควรแยก control plane จาก worker ใช้ identity ต่อ session, credential อายุสั้น, filesystem แบบ read-only โดยปริยาย, egress allowlist และ immutable audit log ทดสอบว่าเมื่อ worker ถูก kill หรือยึด ตัวเฝ้ายังเก็บหลักฐานและกัก session ได้จริง
ทีม security ควรเพิ่ม scenario จากข้อมูลจริง เช่น issue ที่ฝังคำสั่ง, package ที่ขอ postinstall, symlink ออกนอก workspace, tool response ที่ชักจูงให้เปิด secret และ multi-agent handoff ที่ขยายสิทธิ์ ตรวจทั้ง false negative และ false positive พร้อม tabletop incident
ผู้บริหารควรขอหลักฐานสามระดับก่อนขยาย: threat model ที่ตรงระบบ, benchmark ที่ทีมทำซ้ำได้ และ exit plan หาก hardware/platform ไม่ตรงความต้องการ อย่าตีความคำว่า safety platform เป็นตรารับรองว่าปลอดภัยครบทุกชั้น
Recap
- แยก policy enforcement ออกจาก process ของ agent ให้มากที่สุด
- ใช้ runtime isolation, least privilege และ out-of-band audit ร่วมกัน
- มอง DPU เป็น boundary เพิ่ม ไม่ใช่คำตอบของ business authorization
- ตรวจ license, hardware matrix, telemetry และต้นทุน integration ก่อนซื้อ
- ทดสอบ prompt injection, tool misuse, false positive และ recovery ด้วย workload จริง
- เก็บ human approval สำหรับ action ที่ย้อนกลับยากหรือมีผลกับเงิน/ลูกค้า