ย้ายบล็อกใหญ่ไป Astro/CMS ใหม่แบบไม่ลุ้นดวง: 6 ด่านจาก Cloudflare
การย้ายบล็อกไม่ใช่แค่ย้าย Markdown จากกล่องหนึ่งไปอีกกล่อง ถ้าระบบมีผู้เขียนหลายคน งานแปล SEO ภาพจำนวนมาก scheduled posts และทราฟฟิกที่เดี๋ยวเงียบเดี๋ยวพุ่ง สิ่งที่เรากำลังย้ายคือสายการผลิตทั้งโรงงานครับ
Cloudflare เผยรายละเอียดเมื่อ 24 สิงหาคม 2026 ว่าย้ายบล็อกไป EmDash ซึ่งเป็น CMS ที่ทำงานกับ Astro และ Cloudflare การย้ายนี้น่าสนใจไม่ใช่เพราะชื่อเครื่องมือ แต่เพราะทีมเริ่มจากคำถามสองข้อที่วัดได้: มันรองรับงานจริงของเราไหม และมันรับ scale จริงได้ไหม
ด่าน 1: ทดสอบงานของคนก่อนทดสอบเครื่อง
ทีมเริ่มจาก flow ที่บรรณาธิการทำทุกวัน เช่นสร้างบทความ publish/unpublish, schedule และเพิ่ม media สิ่งที่พบไม่ใช่ปัญหา “หน้าเว็บเปิดไม่ได้” แต่เป็นช่องว่างเรื่อง scale ของ media กับ search, localization, SEO, Content Security Policy และ UX ของ editor
จุดพลาดใหญ่คือ scheduled posts ยังใช้ไม่ได้จนถึง EmDash 0.19.0 บทเรียนคือ happy path ของนักพัฒนาไม่เท่ากับ critical path ของผู้ใช้ ถ้ารายได้หรือชื่อเสียงผูกกับการเผยแพร่ตรงเวลา ปุ่ม Schedule ต้องเป็น acceptance test ระดับแรก ไม่ใช่รายการเสริมท้ายโครงการ
ก่อน migration ให้ทำรายการงานตาม persona: คนเขียน, editor, translator, SEO, incident responder และคนดูแล media แล้วทดสอบวงจรเต็มตั้งแต่ draft ถึง rollback เครื่องมือใหม่อาจ render หน้าได้สวย แต่ยังไม่พร้อมรับงานจริงถ้าคนหลังบ้านต้องคอยแก้มือ
ด่าน 2: ใช้ traffic shape จริง ไม่ใช่ค่าเฉลี่ยสวย ๆ
Cloudflare ระบุว่าบล็อกมีโหลดปกติราว 75 requests per second แต่พุ่งเกิน 5,000 RPS ได้ ทีมจึงใช้ทั้ง ramp, breakpoint และ burst test สูงถึง 7,000 RPS พร้อม threshold ของ failure rate และ latency
ค่าเฉลี่ยเหมือนบอกว่าร้านอาหารมีลูกค้าเฉลี่ยชั่วโมงละ 20 คน แต่ไม่บอกว่า 18 คนเข้าพร้อมกันตอนเที่ยง ระบบที่ผ่าน average load อาจล้มตรงนาทีที่บทความกำลังไวรัลพอดี
สิ่งที่ควรยืมไปใช้คือกำหนด failure ล่วงหน้า เช่น error rate เท่าไรถือว่าไม่ผ่าน, p95/p99 latency เท่าไรยอมรับได้ และทดสอบทั้งการไต่โหลดกับโหลดกระแทก อย่าดูกราฟหลังทดสอบแล้วค่อยเลือกเส้นที่ทำให้ผลดูดี
ด่าน 3: Cache เป็นสถาปัตยกรรม ไม่ใช่ปุ่มเร่ง
สถาปัตยกรรมใหม่วาง EmDash บน Worker หลัง Workers Cache ใช้ object cache บน Workers KV และเชื่อมฐานข้อมูลผ่าน Hyperdrive กับ PlanetScale หลายชั้นนี้ทำให้ static files ราว 99.5% และ requests ราว 70% ถูกตอบจาก cache ตามข้อมูลที่ Cloudflare รายงาน
แต่ cache แต่ละชั้นต้องตอบคำถามเรื่อง freshness, invalidation และ fallback ให้ชัด ถ้า editor กด publish แล้ว reader เห็นข้อมูลเก่า เราไม่ได้มีเว็บเร็ว เรามีเว็บที่ตอบผิดเร็วขึ้น
ก่อนเพิ่ม cache จึงควรเขียน data journey หนึ่งรอบว่า content ถูกเขียนที่ไหน, ใคร invalidate อะไร, stale ได้นานเท่าไร และเมื่อฐานข้อมูลล่ม reader ยังอ่านหน้าเดิมได้หรือไม่ เมื่อ contract เหล่านี้ชัด cache ถึงจะเป็นเกราะความทนทานแทนกับดักความซับซ้อน
ด่าน 4: แยก redesign ออกจากความถูกต้อง แต่ใช้โอกาสเดียวกัน
Cloudflare ปรับ visual language, dark mode, accessibility และย้าย subscription form ที่คนเคยเข้าใจผิดว่าเป็น search box นี่สะท้อนว่าการย้าย platform เป็นโอกาสแก้ UX debt ได้ แต่ไม่ควรให้ความสวยบัง migration gate
แนวทางที่ปลอดภัยคือมี checklist คนละชุด: content parity, routing/redirects, SEO, accessibility, performance และ visual regression ถ้าหน้าใหม่สวยแต่ canonical URL หาย หรือ code block อ่านไม่ได้ใน dark mode ก็ยังไม่พร้อมส่งทราฟฟิก
ด่าน 5: วาง proxy และ fallback ก่อนวันเปิดตัว
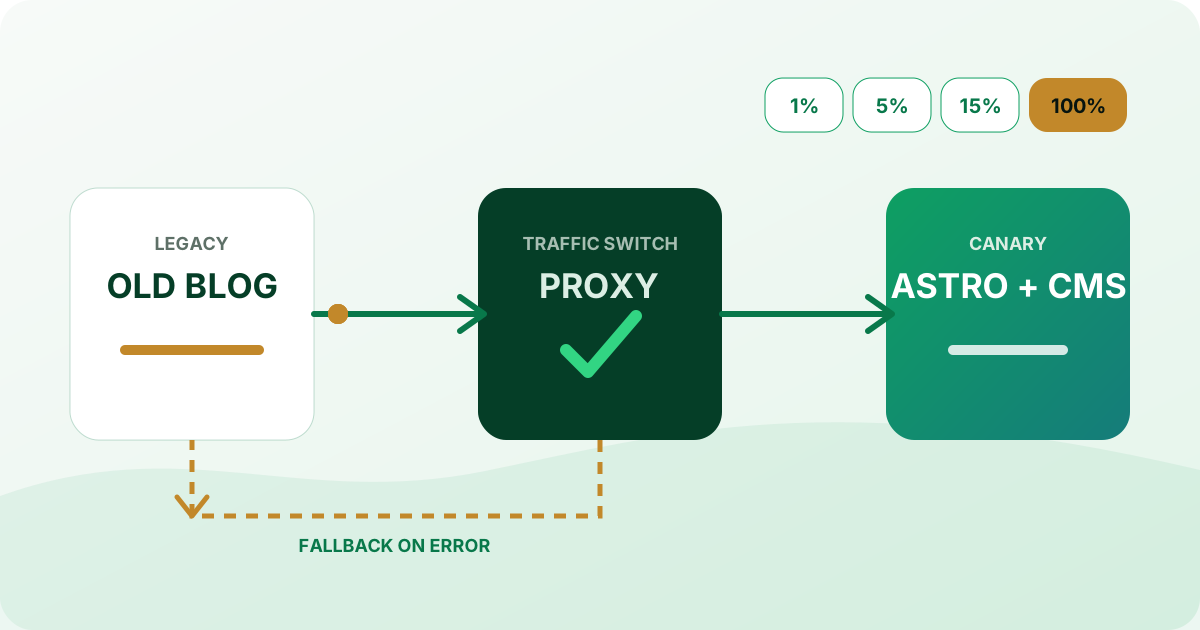
หัวใจของ rollout คือ proxy Worker ที่ route request ระหว่างบล็อกเดิมกับระบบใหม่ผ่าน version cookie และ fallback ไป legacy เมื่อระบบใหม่ตอบ 500 ทีมยังใช้ service binding เชื่อม Worker โดยตรง เพื่อลดเส้นทาง public DNS/TLS ระหว่าง proxy กับแอปใหม่
หลักคิดนี้ใช้ได้แม้เราไม่ได้ใช้ Cloudflare Workers: วาง traffic switch ที่เปลี่ยนได้เร็ว, ทำ health signal ที่เครื่องตัดสินได้ และเก็บระบบเดิมให้อยู่ในสภาพรับงานจนกว่าระบบใหม่จะนิ่ง คำว่า rollback ไม่ควรแปลว่า “deploy commit เก่าหวังว่าจะทัน”
ด่าน 6: Canary จาก 1% ไป 100% พร้อมดูระบบจริง
วันเปิดตัว Cloudflare เริ่มที่ 1% แล้วขยับเป็น 5%, 15% และสูงขึ้นหลังตรวจสุขภาพระบบ ก่อนย้ายครบ 100% ภายในวันเดียว ขั้นบันไดนี้ลด blast radius หรือพื้นที่ความเสียหาย ถ้า edge case โผล่ตอน 1% คนส่วนใหญ่ยังอยู่บนระบบเดิม
แต่ตัวเลขเปอร์เซ็นต์ไม่ใช่พิธีกรรม ทุกขั้นต้องมีเวลา observe, metric ที่ใช้ตัดสิน และเงื่อนไข rollback ถ้าขยับ 1 → 5 → 15 → 100 ภายในไม่กี่นาทีโดยไม่มีข้อมูลใหม่ เราเพียงกด deploy สี่ครั้ง
หลังย้าย Cloudflare รายงานว่า p95 response latency นิ่งขึ้น มี error น้อย และรองรับโหลดจริงถึง 850 RPS ในช่วงที่วัด นี่เป็นหลักฐานหลัง rollout ไม่ใช่เหตุผลให้ข้าม pre-production load test ทั้งสองส่วนต้องทำงานคู่กัน
Checklist ฉบับทีมเล็ก
ทีมไม่จำเป็นต้องมี traffic หลายพัน RPS เพื่อใช้บทเรียนนี้ เริ่มแบบเล็กได้ด้วยหกคำถาม:
- งานสำคัญของ writer/editor ผ่านครบหรือยัง รวม schedule และ media?
- source URL, redirect, metadata และภาพเก่าอยู่ครบหรือไม่?
- โหลดปกติ, burst และ failure threshold คือเท่าไร?
- cache invalidation กับ stale window มีเจ้าของหรือยัง?
- traffic switch และ fallback ทดสอบจริงแล้วหรือยัง?
- แต่ละ canary step ต้องเห็น metric อะไรก่อนขยับต่อ?
ถ้าตอบไม่ได้ข้อใดข้อหนึ่ง ให้แก้ contract ก่อนเพิ่มเครื่องมือ Migration ที่ดีไม่ใช่โครงการที่ไม่มีปัญหา แต่เป็นโครงการที่ปัญหาเกิดในวงเล็ก มองเห็นเร็ว และย้อนกลับได้
Recap
บทเรียนจาก Cloudflare คือ Astro หรือ CMS ใหม่ไม่ได้ทำให้ migration ปลอดภัยเอง ความปลอดภัยเกิดจากการทดสอบ flow ของคน, จำลอง traffic shape, ออกแบบ cache contract, เตรียม fallback และส่งทราฟฟิกแบบ canary
เริ่มจาก WHY ว่าอะไรห้ามหายและอะไรห้ามล่ม แล้วค่อยเลือก HOW ที่ทำให้ตรวจสอบได้ เมื่อระบบเดิมยังพร้อมรับงานและระบบใหม่ต้องพิสูจน์ตัวเองทีละเปอร์เซ็นต์ วันเปิดตัวจะกลายเป็นการขยับคันโยกอย่างมีข้อมูล แทนการโยนเหรียญลุ้นครับ