Tag: performance
56 รายการ
Blog
TornadoVM 7.0 เพิ่ม TileContext API: อีกทางเขียนงาน GPU จากโค้ด Java
TornadoVM 7.0.0 เปิดตัว TileContext API ใหม่ ช่วยให้เขียนโค้ด Java แล้วรันบน GPU ได้ง่ายขึ้น เหมาะกับนักพัฒนา Java ที่ทำ ML inference, ประมวลผลภาพ หรือคำนวณการเงิน batch ใหญ่ๆ มาดูกันว่ามันช่วยเรื่องงานและเงินยังไง
Python 3.15 อัปเกรด JIT: เครื่องยนต์ใหม่ เร็วขึ้นแบบไม่ต้องเปลี่ยนพวงมาลัย
Python 3.15 มาพร้อม JIT compiler รุ่นใหม่ แรงขึ้น 7–12% บน Linux/Mac เครื่องผู้ใช้ไม่ต้องติดตั้งอะไรเพิ่ม เหมือนได้เครื่องยนต์รถใหม่แต่ขับเหมือนเดิม
Bun 1.4.3 CompressionStream: ตั้งระดับบีบอัดให้ตรง latency budget
ใช้ CompressionStream level เลือกสมดุล CPU กับขนาดข้อมูล พร้อม Bun test แบบ round-trip โดยไม่พึ่งเครือข่าย
Java เสนอปรับแรมเองใน JDK 28 เริ่มไวขึ้น แต่บิลคลาวด์จะลดจริงไหม
ข้อเสนอ ZGC ช่วยแอป Java เริ่มไวและปรับหน่วยความจำตามงาน อธิบายผลทดลอง เงื่อนไขเปิดใช้ และสิ่งที่ทีมระบบกับคนคุมงบควรวัดก่อนหวังลดบิลคลาวด์
Go strings.FieldsFuncSeq: แยก token แบบ iterator ไม่ต้องสร้าง slice ทั้งก้อน
ใช้ FieldsFuncSeq เดิน token ทีละค่า หยุดได้เร็ว และคัดลอกเฉพาะข้อมูลที่ต้องเก็บ พร้อม Go test
Rust Vec::spare_capacity_mut: เติม buffer ที่จองไว้โดยไม่สร้าง Vec ชั่วคราว
เรียนรู้ MaybeUninit, set_len invariant และ panic boundary ผ่านตัวอย่างเติมข้อมูลที่ทดสอบจริง
Go bytes.Buffer.AvailableBuffer: ต่อข้อมูลลงพื้นที่ว่างโดยลด allocation
ใช้ AvailableBuffer คู่ strconv.Append* อย่างถูกสัญญา พร้อมทดสอบการเขียน CSV, capacity และข้อห้ามเก็บ slice ข้าม Write
Java เตรียมลดเวลารอหลังเปิดระบบ ด้วย JEP 544 ใน JDK 28
Java เตรียมเก็บโค้ดที่ปรับให้เร็วไว้ใช้ตั้งแต่เปิดระบบ อ่านว่าคนใช้บริการได้อะไร และทีม IT ต้องตรวจอะไร ก่อนเชื่อผลทดสอบหรือคาดหวังว่าค่าเครื่องจะลดลง
Java BitSet.nextSetBit: เดินเฉพาะตำแหน่งที่เปิดโดยไม่สแกนทุกช่อง
ใช้ BitSet.nextSetBit วน sparse flags พร้อมหลีกเลี่ยง off-by-one และแยก index set จาก business identity
Go slices.Grow กับ Clip: จองความจุให้พอ แล้วคืนส่วนเกินตรงขอบงาน
ใช้ slices.Grow ลดการขยาย backing array ซ้ำ และ slices.Clip ตัด capacity ก่อนส่งข้อมูลข้าม boundary พร้อม Go tests ที่รันจริง
Inside Java: JDK 27 เร็วขึ้นจากอะไร — Compact Headers และ G1 เป็นค่าเริ่มต้น
สรุปบทความ Inside.java 28 ก.ย. 2026 เรื่องผลงาน JDK 27: Compact Object Headers และ G1 default ทั่วเครื่อง, HashMap.putAll เร็วขึ้น, และคำแนะนำวัดผลตอนอัปเกรด
Bun.nanoseconds: จับเวลาช่วงสั้นด้วยนาฬิกา monotonic
วัด elapsed time ของโค้ดด้วย Bun.nanoseconds โดยไม่สับสนกับเวลาปฏิทิน พร้อมตัวอย่างที่รันจริง
Python memoryview.cast: เปลี่ยนมุมมอง bytes โดยไม่ copy
อ่านบัฟเฟอร์เดิมเป็นสมาชิกชนิดใหม่ด้วย memoryview.cast พร้อมตรวจ alignment เชิงรูปแบบและ byte order
Go 1.27 portable SIMD: เร่งงานเวกเตอร์โดยไม่ผูก CPU
อ่านข้อเสนอ simd แบบพกพาใน Go 1.27 ตั้งแต่ vector width, tail, emulation ถึงเกณฑ์วัดผลก่อนใช้จริง
Go reflect.TypeAssert: ตรวจชนิดจาก reflect.Value โดยไม่สร้าง interface กลาง
ย้ายจาก Value.Interface().(T) มาใช้ reflect.TypeAssert พร้อมอธิบายกรณีที่แก้ได้และขอบเขตของ reflection
Rust Vec::retain_mut: แก้ค่าและกรองสมาชิกในรอบเดียวโดยรักษาลำดับ
ใช้ retain_mut ทำ normalization ก่อนตัดค่าที่ไม่ผ่าน พร้อมเข้าใจ ownership, panic และต้นทุนการเลื่อนข้อมูล
Go unique.Handle: ทำคีย์ซ้ำให้เหลือตัวแทนเดียวก่อนเก็บในแคช
ใช้ unique.Make สร้าง handle ที่เทียบได้เร็ว พร้อมขอบเขตเรื่องอายุข้อมูลและหน่วยความจำ
Go CSV ReuseRecord: อ่านไวขึ้นโดยไม่เก็บ slice ที่ถูกใช้ซ้ำ
ใช้ encoding/csv.Reader.ReuseRecord กับ stream และคัดลอก record ก่อนเก็บข้ามรอบอ่าน
Python 3.15: bytearray.take_bytes — ดึง bytes ออกจากบัฟเฟอร์โดยไม่คัดลอกเกินจำเป็น
สรุป bytearray.take_bytes ใน Python 3.15 สำหรับพาร์สโปรโตคอล/บัฟเฟอร์เครือข่าย — คืน bytes แล้วตัดออกจาก bytearray
Zig std.mem.window: ทำ Sliding Window โดยคืน Slice ไม่คัดลอกข้อมูล
ใช้ std.mem.window สร้าง moving window, chunk และ sampling พร้อมระวัง tail slice กับ size/advance ที่ห้ามเป็นศูนย์
Go 1.27 แยกทางด่วนให้ Allocation ก้อนเล็ก: เร็วขึ้นโดยไม่ต้องแก้โค้ด
เจาะกลไก size-specialized allocation ของ Go 1.27 ว่าทำไมก้อนต่ำกว่า 80 ไบต์เร็วขึ้น และจุดไหนยังควรลด allocation เอง
heapq.nlargest / nsmallest: หยิบ Top-N โดยไม่ sort ทั้งก้อน
ใช้ heapq.nlargest และ nsmallest จาก docs.python.org ดึงค่าสูงสุด/ต่ำสุด n ตัว พร้อมตัวอย่างรันจริง
Python lru_cache: จำผลคำนวณซ้ำให้ฟังก์ชันบริสุทธิ์เร็วขึ้น
อธิบาย functools.lru_cache แบบสั้น พร้อม unittest ที่พิสูจน์ว่าเรียกซ้ำไม่คำนวณใหม่
Turbopack แบ่ง JavaScript Chunk อย่างไร: ปรับโหลดหน้าโดยไม่ไล่แตก Bundle แบบเดาสุ่ม
สรุปแนวคิด chunking จากทีม Next.js พร้อมวิธีวัด shared code, navigation cost และขอบเขตของ experimental controls
ย้าย Gatsby ไป Astro ใน 9 วันโดยไม่เขียน React ใหม่: บทเรียนจาก Evil Martians
ถอดกลยุทธ์ migration ที่เก็บ React components เดิมไว้ ลด JavaScript ตอนโหลด 61% และค่อยปรับ hydration หลัง cutover
Python cached_property: คำนวณครั้งเดียว แต่อย่าลืมออกแบบจังหวะล้าง cache
เข้าใจการเขียนทับ การลบเพื่อคำนวณใหม่ ข้อจำกัดของ __dict__ และ race ที่ยังเกิดได้
functools.cache กับ lru_cache: เมื่อไหร่ควรจำกัดขนาดแคช
เทียบ @cache กับ @lru_cache จากเอกสาร Python พร้อมตัวอย่างรันได้และเกณฑ์เลือกใช้
Python bisect key=: ค้นช่วงในข้อมูลเรียงโดยไม่เรียก key ซ้ำเกินจำเป็น
ใช้ bisect_left กับ key อย่างถูกชนิด และเลือก precomputed keys หรือ cache เมื่อต้องค้นซ้ำบนข้อมูลเดิม
Python heapq.merge: รวม stream ที่เรียงแล้วโดยไม่กองทั้งหมดใน RAM
ใช้ heapq.merge รวมหลาย iterable แบบ lazy พร้อมเงื่อนไขข้อมูลต้องเรียงและผลต่อ memory เมื่อเทียบกับ sorted
React Native FlatList: ทำ viewability config ให้อ้างอิงคงที่
ลด callback สั่นและ error จากการเปลี่ยน viewabilityConfig ระหว่าง render ด้วย ref และแยกนโยบายการมองเห็นออกจาก UI state
Rust 1.98: substr_range คืนช่วง byte ของ slice โดยไม่ค้นซ้ำ
ทำความเข้าใจ str::substr_range สำหรับเชื่อม string slice กลับสู่ตำแหน่งต้นฉบับ พร้อมข้อจำกัดเรื่อง provenance และ UTF-8
functools.lru_cache: จำผลคำนวณซ้ำโดยไม่ต้องเขียนแคชเอง
อธิบาย lru_cache จาก stdlib พร้อมตัวอย่างรันได้ ตารางเลือก maxsize และข้อควรระวังเรื่องอาร์กิวเมนต์ที่แฮชได้
Java Optional: orElse สร้างค่าทิ้งได้ ส่วน orElseGet ทำเมื่อจำเป็น
เห็นผลของ eager กับ lazy fallback ชัด ๆ พร้อม assertion ที่กัน side effect เกิดทั้งที่มีค่าอยู่แล้ว
React Native 0.87: Metro ใช้แรมน้อยลงครึ่งหนึ่ง แต่ config เก่าต้องเก็บกวาด
แยกผลของ source map storage ออกจาก migration ของ config เพื่ออัป bundler โดยไม่ปนหลายความเสี่ยง
Bun 1.4.2 แก้ AsyncLocalStorage กัก context ไว้นานเกินงาน
แพตช์ regression ที่ค่าระดับ request ยังถูกอ้างถึงโดย timer และ promise พร้อม smoke test ก่อน rollout
Rust 1.98 format_into: แปลงเลขเป็นข้อความโดยไม่ดึง crate เพิ่ม
รู้จัก NumBuffer และ format_into สำหรับ hot path พร้อมเหตุผลที่ไม่ควรแทน format! ทุกจุด
JEP 537: Vector API รอบที่สิบสองใน JDK 27
สรุป JEP 537 ที่ re-incubate Vector API ใน JDK 27 โดยไม่เปลี่ยน API และอัปเดตไลบรารี SLEEF
Python 3.15 Tachyon: โปรไฟล์แบบสุ่มตัวอย่างโดยไม่ฝังโค้ดในโปรเซส
สรุปโมดูล profiling.sampling ชื่อ Tachyon ใน Python 3.15 ที่แนบ PID ได้ สร้าง flame graph และเหมาะกับโปรดักชันเพราะโอเวอร์เฮดเกือบศูนย์
Bun 1.4 รันหลาย Script พร้อมกัน: ใช้ --parallel โดยยังอ่าน Log รู้เรื่อง
จัดงาน build และ lint ที่เป็นอิสระให้รันพร้อมกันด้วย bun run --parallel พร้อมขอบเขตที่ควรกลับไปใช้ sequential
lazy import ใน Python 3.15: เลื่อนโหลดโมดูลจนกว่าจะถูกใช้จริง
อธิบาย PEP 810 Explicit lazy imports ที่มากับสาย Python 3.15 เหมาะกับ CLI และแอปที่ import หนักตั้งแต่เปิดโปรแกรม
Bun 1.4 อ่าน CPU Profile เป็น Markdown: หา Hot Function ก่อนเดา
ใช้ --cpu-prof-md สร้างรายงาน Markdown จากโปรแกรม TypeScript และอ่านสัดส่วน CPU เพื่อหา bottleneck อย่างมีหลักฐาน
Rust 1.98 เปิดทางคำนวณ Float แบบ Algebraic: เร็วขึ้นได้ แต่คำตอบอาจขยับ
เข้าใจเมธอด algebraic_* ใหม่ของ Rust 1.98 ว่าแลกความคงที่ของเลขทศนิยมกับโอกาส vectorize อย่างไร และงานแบบไหนไม่ควรใช้
Lynx 4 วิเคราะห์ก่อนอัปเกรด: Runtime CSS, Streaming Fetch และรั้วกัน JavaScript ค้าง
พี่โชว์คัดของสำคัญจาก Lynx 4 สำหรับทีม mobile ตั้งแต่ runtime CSS และ progressive image ถึง JS timeout guard พร้อมแผนทดลองที่วัดผลได้
Astro 7.2 Incremental Builds: เร่งเว็บใหญ่ด้วย cacheKey โดยไม่เสี่ยงหน้าเก่า
พี่โชว์อธิบายกลไก incremental static builds แบบทดลองของ Astro 7.2 และแผน rollout สำหรับเว็บบทความที่ต้องพิสูจน์ cache invalidation ก่อนเปิดใช้
Zig Workshop #6: 1 ล้านบรรทัดใน 62 มิลลิวินาที และส่งขึ้นทุกแพลตฟอร์ม
บทจบของ workshop zlog — เก็บข้อมูลแบบ struct-of-arrays เพื่อคำนวณ percentile, เทียบเวลา Debug กับ Release ที่ต่างกัน 14 เท่า, คอมไพล์ binary ให้ห้าแพลตฟอร์มจากเครื่องเดียว และ benchmark เทียบกับ awk และ Python บนไฟล์ 94 MB เดียวกันที่ reproduce ได้
Zig 0.16 บทที่ 9: เลือก allocator ให้ถูกงาน และของที่หายไปใน 0.16
สวนสัตว์ allocator ของ Zig 0.16 — arena ที่ทำให้โค้ดคืนหน่วยความจำหายไปเกือบหมด (วัดได้ว่าลดการขอจาก 50 ครั้งเหลือ 5), FixedBufferAllocator, MemoryPool, stackFallback พร้อมทางย้ายสู่ BufferFirstAllocator ใน 0.17, DebugAllocator vs smp_allocator และรายชื่อ allocator ที่ถูกลบทิ้งใน 0.16
Jalapeño ชิป Inference ของ OpenAI: ทำไม Latency กับไฟต้องวัดพร้อมกัน
อ่านผลทดสอบชิป Jalapeño แบบไม่หลงตัวเลข แยก prefill, decode, throughput และ performance per watt เพื่อมองผลต่อ AI agent จริง
Zig Optimization #5: buffer เดียวเปลี่ยน 1,173 ms เป็น 3 ms และของที่แก้แล้วไม่ต่าง
บทปิดของชุด optimization — กราฟขนาด buffer ที่ต่างกัน 375 เท่า, ต้นทุนของ format ที่ต้องแยกให้ออกจากต้นทุน syscall และรวมทุกเคสที่ผมวัดแล้วพบว่าแก้ไปก็ไม่ดีขึ้น ซึ่งมีค่าพอ ๆ กับเคสที่ดีขึ้น
Zig Optimization #4: pointer chasing ช้ากว่า array 247 เท่า แต่ SoA ชนะแค่ 9%
วัดการจัดวางข้อมูลบน 2 ล้านแถว — struct-of-arrays ชนะน้อยกว่าที่คนเล่ากันเยอะ, การเปลี่ยน usize เป็น u32 ไม่ได้ช่วยเลยแม้แต่นิดเดียว แต่การเดิน linked list ที่ node กระจัดกระจายช้ากว่า array 247 เท่า
Zig Optimization #3: เลิก copy ข้อความ และใช้ hash map ให้ถูกวิธี
วัดจริงบนงานนับความถี่ 200,000 ครั้ง — การสร้างข้อความใหม่ทุกรอบช้ากว่า interning 4 เท่า, contains+get+put ช้ากว่า getOrPut เกือบ 3 เท่า และการแปลง key เป็น u32 handle เร็วกว่าทุกวิธี 40 เท่า พร้อมผลตามความยาว key ที่ 16, 64 และ 256 ไบต์
Zig Optimization #2: การขอหน่วยความจำสองแสนครั้ง เหลือสองครั้ง
วัดจริงว่านิสัยขอหน่วยความจำที่ติดมาจาก Java, Go และ Python แพงแค่ไหนใน Zig — create ในลูปช้ากว่า arena 3 เท่า, การจองล่วงหน้าลดการขยายจากยี่สิบกว่ารอบเหลือศูนย์ และเคสที่ MemoryPool กลับไม่ชนะ arena เลยทั้งที่ทฤษฎีบอกว่าควรชนะ
Zig Optimization #1: ก่อนจะปรับให้เร็ว ต้องวัดให้ถูกก่อน
std.time.Timer หายไปจาก Zig 0.16 แล้ว และการเทียบ Debug กับ Release ตรง ๆ ให้ตัวเลขที่เกินจริงหกเท่า เพราะ init.gpa สลับ allocator ตาม build mode — บทนี้สร้าง harness ที่ใช้ได้จริงและพิสูจน์ว่าตัวเลขที่คนแชร์กันหลอกตรงไหน
Rust ลด RAM ให้ DNS Cache: บทเรียนจาก 250,000 ล้านรายการของ Cloudflare
แกะ 5 แนวคิดลด memory footprint จากระบบ DNS ของ Cloudflare พร้อมตัวอย่าง Rust ที่ทดสอบจริงว่าโครงสร้างแบบ growable กับ frozen layout ต่างกันอย่างไร
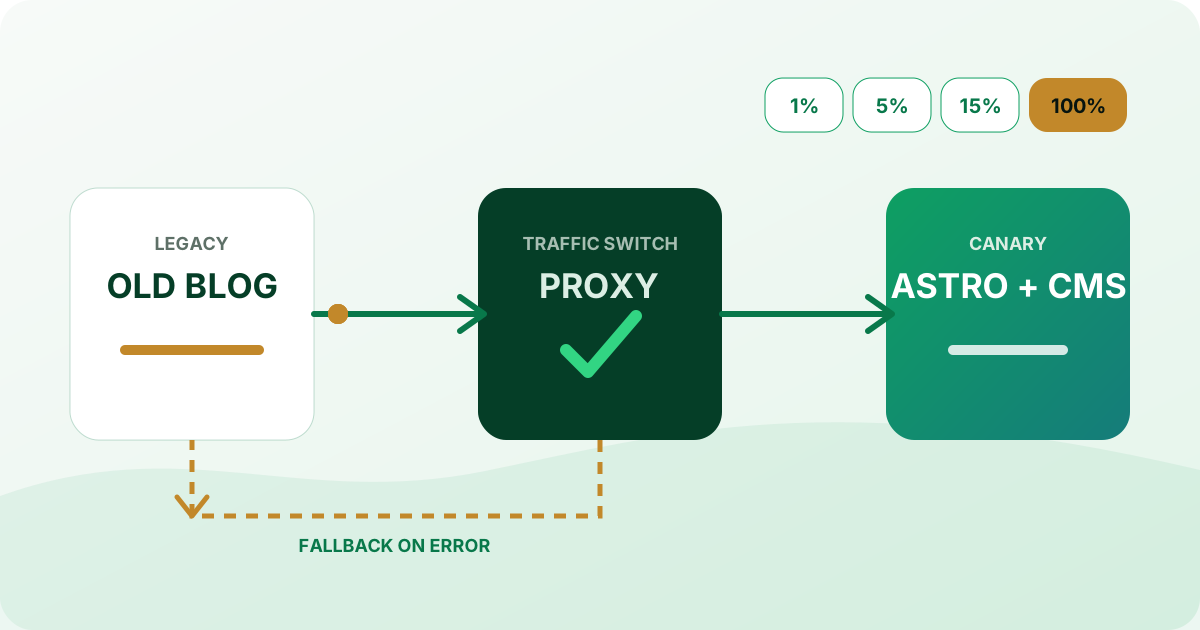
ย้ายบล็อกใหญ่ไป Astro/CMS ใหม่แบบไม่ลุ้นดวง: 6 ด่านจาก Cloudflare
สรุปบทเรียน Customer Zero, load test, cache หลายชั้น และ canary rollout จากการย้าย Cloudflare Blog ไป EmDash บน Astro โดยเริ่มจากความเสี่ยงก่อนเครื่องมือ

อัปเกรด Astro 6 → 7 บนบล็อกตัวจริง: วัดผลก่อน-หลัง แล้วมันคุ้มไหม?
เราอัปเกรดบล็อกนี้จาก Astro 6 เป็น Astro 7 จริง ๆ แล้ววัด build time / ขนาดไฟล์ ก่อน-หลังแบบไม่โม้ มาดูกันว่าได้อะไรเพิ่ม เสียอะไรไป และงานแบบไหนควรเปลี่ยน
ทำไม Astro ถึงเร็วมาก?
เจาะลึกเทคนิค Islands Architecture ที่ทำให้ Astro ส่ง zero JavaScript by default