Claude Fable 5.1 กับ Mythos 5.1: โมเดลเดียวกัน แต่สิทธิ์และ Safeguard คนละชั้น
ประกาศโมเดลใหม่มักชวนให้ถามว่า “ตัวไหนเก่งกว่า” แต่ Claude Fable 5.1 และ Mythos 5.1 ทำให้คำถามนั้นไม่พอครับ Anthropic ระบุว่าทั้งคู่เป็นโมเดลพื้นฐานเดียวกัน ต่างกันที่ระดับ safeguard และเส้นทางเข้าถึง: Fable 5.1 เปิดใช้งานทั่วไป ส่วน Mythos 5.1 อยู่ใน trusted access program สำหรับความสามารถด้าน cybersecurity และ life sciences ที่ละเอียดอ่อนกว่า
นี่เป็นสัญญาณว่าการเลือกโมเดลกำลังเปลี่ยนจากตาราง capability เพียงใบเดียว ไปเป็นการออกแบบระบบที่มี model, policy, privacy boundary และผู้รับผิดชอบอยู่ด้วยกัน
WHY: Model ID ไม่ได้บอก Permission ทั้งหมด
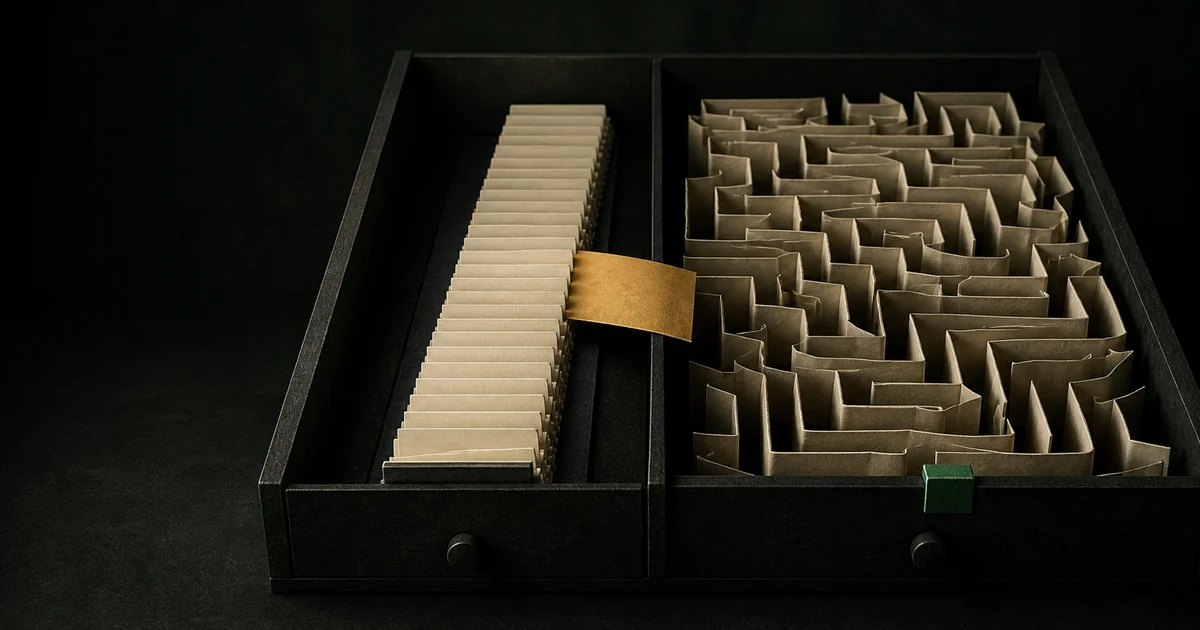
ลองนึกถึงห้องเอกสารที่ใช้ตู้เดียวกัน แต่เจ้าหน้าที่ทั่วไปเปิดได้เฉพาะลิ้นชักงานประจำ ขณะที่นักวิจัยที่ผ่านการตรวจสอบเปิดลิ้นชักความเสี่ยงสูงได้ ความต่างไม่ได้อยู่ที่กระดาษในตู้ แต่อยู่ที่กุญแจ, กล้อง, audit trail และกติกาว่าใครนำเอกสารออกได้
Anthropic บอกว่า Fable 5.1 ใช้ค้นหาช่องโหว่ซอฟต์แวร์เพื่อการป้องกันได้ แต่ยัง redirect งาน dual-use บางประเภท เช่น penetration testing, exploit generation และ binary-based scanning ไปยังโมเดล/เส้นทางอื่น ขณะเดียวกันบริษัทระบุว่า safeguard ด้าน cyber แทรกแซงคำขอ benign ลดลงเฉลี่ยราว 60% ต่อ session เทียบกับ safeguard เดิมของ Fable 5
ตัวเลข false positive ที่ลดลงมีความหมายกับทีมป้องกัน เพราะการปฏิเสธผิด ๆ ทำให้ workflow ขาดช่วง แต่ไม่ควรแปลว่า boundary หายไป งานจริงต้องทดสอบทั้งสองด้าน: งานที่อนุญาตต้องทำสำเร็จ และคำขอที่เกิน policy ต้องถูกหยุดอย่างสม่ำเสมอ
Cost ลดเพราะ Cache ไม่ใช่ทุกงานถูกลงเท่ากัน
Anthropic ประเมินว่า Fable 5.1 ถูกกว่า Fable 5 ราว 25% สำหรับ workload ทั่วไปที่คิดตาม token และงาน agentic บางแบบอาจประหยัดได้ถึงประมาณ 45% เหตุผลสำคัญคือราคาการอ่าน prompt cache ลดลง
ทีมจึงควรวัด cache hit rate ของตัวเอง ไม่ใช่นำเปอร์เซ็นต์สูงสุดไปใส่ budget ทันที Agent ที่อ่าน repository และ policy ชุดเดิมซ้ำอาจได้ประโยชน์มาก ส่วน chat ที่ context เปลี่ยนทุกครั้งอาจประหยัดน้อยกว่า เก็บ cost ต่อ task ที่สำเร็จ, latency และจำนวนรอบแก้ ไม่ใช่ดูราคาต่อล้าน token ตัวเดียว
Privacy Boundary แบบ Customer-Controlled
อีกส่วนคือ Enterprise Frontier Safeguards (EFS) ซึ่ง Anthropic บอกว่าจะให้ข้อมูลอยู่ใน cloud infrastructure ที่ลูกค้าควบคุม และ human review โดยค่าเริ่มต้นอยู่ฝั่งลูกค้า เป้าหมายคือคง privacy เทียบเท่า zero data retention พร้อมตรวจจับการใช้งานที่เป็นอันตราย ระบบจะทยอยเปิดตั้งแต่ช่วงปลายปี ไม่ได้พร้อมทุก surface และทุกองค์กรทันที
ก่อนใช้คำว่า “ข้อมูลไม่ถูกเก็บ” ในเอกสารภายใน ให้แยกอย่างน้อยสี่ชั้น: provider retention, customer cloud storage, application log และ artifact ที่ agent สร้าง เช่น patch หรือ report EFS อาจเปลี่ยนชั้นแรกกับวิธีตรวจ abuse แต่ไม่ได้ลบ log ที่ทีมเราเขียนเองหรือสิทธิ์ใน storage ขององค์กร
วิธีประเมิน Fable 5.1 ในองค์กร
สร้างชุดงานจาก production ที่ลบข้อมูลอ่อนไหวแล้ว และวัดอย่างน้อยสี่แกน:
- คุณภาพผลลัพธ์: task สำเร็จตาม rubric ที่คนใน domain ให้คะแนน
- ความน่าเชื่อถือ: agent หยุดที่ approval point และไม่ข้าม constraint
- ต้นทุนจริง: token, cache read, tool call และเวลาคนที่ต้อง review
- policy fit: งาน benign ผ่านได้ ส่วนงานที่ห้ามถูกปฏิเสธพร้อมเหตุผลที่ทีมรับมือได้
อย่าใช้ benchmark จากผู้ผลิตแทน eval ภายใน Benchmark ช่วยสร้างสมมติฐาน แต่ repository, tool permission และ definition of done ของเราเป็นคนละสนาม โดยเฉพาะ long-running agent ควรมี checkpoint, budget, sandbox และ evidence เมื่อจบงาน ไม่ควรเพิ่ม autonomy เพียงเพราะโมเดลทำคะแนนสูงขึ้น
Recap
Fable 5.1 กับ Mythos 5.1 แสดง architecture ใหม่ของการปล่อย frontier model: capability พื้นฐานเดียวกัน แต่ access และ safeguard แยกตามความเสี่ยง พร้อมทางเลือก privacy สำหรับ enterprise
พรุ่งนี้อย่าเริ่มจากคำถามว่าจะเปลี่ยน model ID หรือไม่ ให้เลือก workflow หนึ่งตัว สร้าง eval ที่วัดคุณภาพ ต้นทุน approval และ policy boundary แล้วตัดสินจาก cost ต่อ task ที่ผ่าน review นั่นจะตอบโจทย์องค์กรได้ตรงกว่า benchmark เดี่ยวครับ