Tag: llm
17 รายการ
Blog
Pydantic AI 2.55.0 ให้บอตพกแชตต่อ พร้อมยอดใช้ที่ไม่เริ่มนับใหม่
Conversation รวมประวัติแชต ยอดใช้งาน และงานรออนุมัติไว้ด้วยกัน อธิบายว่าช่วยร้านค้าอย่างไร และทำไมยังต้องออกแบบการเก็บข้อมูลกับทดสอบก่อนอัปเกรด
Qwen3.8-Max ไป US Virginia: region ใหม่ไม่ใช่ตรารับรอง compliance
วิเคราะห์ Qwen3.8-Max และ Qwen3.7-Max ใน US Virginia ทั้งราคา 1M context, deployment scope, data boundary และ checklist สำหรับทีมไทย
LangChain4j 1.21.0 ให้ AI คัดงานก่อนตอบ บิลจะลดจริงไหม
ทีม Java มีทางเลือกใหม่สำหรับคัดอีเมล เลือกโมเดล และตรวจคำตอบก่อนส่งลูกค้า แต่คำว่าเร็วและถูกยังต้องวัดเอง พร้อมวิธีเริ่มทดลองโดยมีคนรับช่วงเมื่อ AI ไม่แน่ใจ
PoeLLM ยึดเซิร์ฟเวอร์ AI ขุดเหรียญ แถมใช้เครื่องเราโจมตีคนอื่น
ทีมที่เพิ่งตั้ง AI ใช้เองควรตรวจว่าใครเข้าถึงเครื่องได้ PoeLLM ใช้เซิร์ฟเวอร์ที่เปิดสู่อินเทอร์เน็ตขุดเหรียญและหาเหยื่อเพิ่ม พร้อมสิ่งที่ควรตรวจโดยไม่ต้องรอค่าใช้จ่ายผิดปกติ
“ห้องทรมาน AI” ไวรัลจน GitHub ลบแล้วคืน สุดท้ายมีคนทำให้โมเดลบ่น “ท้องผูก” เพื่อพิสูจน์ว่าคำพูดไม่ใช่ความรู้สึก
จากโปรเจกต์ “ห้องทรมาน AI” ที่คนแห่ report จน GitHub ลบแล้วคืน สู่นักพัฒนาที่หมุนปุ่มเดียวกันจน AI บ่นท้องผูก ขำแต่จริง พร้อมอธิบาย activation steering แบบร้านข้าวตามสั่ง และแยกมุกออกจากหลักฐาน
GPT-6.1 Sol เกือบแตะ Astra แต่ราคาถูกกว่าห้าเท่า—คำว่า ‘คุ้ม’ ต้องดูทั้งบิลและ safety review
OpenAI เปิด GPT-6.1 Sol พร้อมบริบท 1.05 ล้านโทเคน ราคาอินพุต 2 ดอลลาร์และเอาต์พุต 10 ดอลลาร์ต่อหนึ่งล้านโทเคน เราแยกตัวเลขจริง คำอ้าง benchmark และข้อจำกัดด้านความปลอดภัยก่อนทีมย้ายงาน
MiniMax ซุ่มปล่อยโมเดล M3.1-Flash-Preview ใน MiniMax Code บริบท 1M คิดลึกได้ 5 ระดับแต่ยังกั๊กราคา API
เจาะลึกการเปิดตัวเงียบของ MiniMax M3.1-Flash-Preview โมเดลเขียนโค้ดบริบท 1 ล้านโทเคน ปรับระดับการคิดได้ 5 ขั้น พร้อมจัดแคมเปญแต้มคูณสอง แต่ยังไม่เปิดราคา API และยังไม่ยืนยันข่าวลือ Space Bunny
Claude Opus 5.5 ลดราคาต่อ task: ก่อนย้ายต้องวัดทั้งคุณภาพ ต้นทุน และสิทธิ์เครื่องมือ
อ่านประกาศ Opus 5.5 แบบไม่รับ benchmark ตรง ๆ พร้อม migration scorecard สำหรับ workload จริง
Grok 4.7: เมื่อโมเดลเก่งขึ้นด้วยการตรวจคำตอบตัวเอง
อ่านประกาศ Grok 4.7 แบบแยกความสามารถ ราคา และข้อจำกัดที่ทีมต้องวัดกับงานจริง
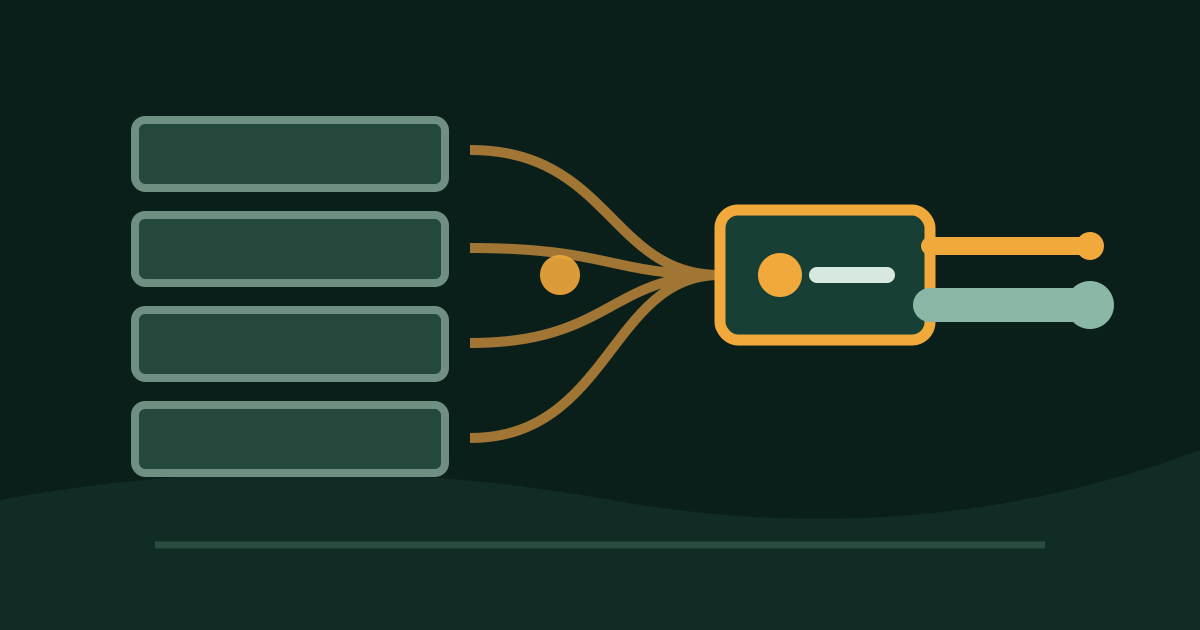
DeepSeek V4.1 Flash ลด KV Cache: ต้นทุน Agent อาจเปลี่ยนก่อนโมเดล Pro รุ่นถัดไปมา
สรุปสถาปัตยกรรม 552B MoE ที่ activate input 8B/output 16B การลด HBM/SSD และการ reroute model aliases วันที่ 14 ก.ย.
Qwen-Drive 1.0 รวมการมองสามมิติกับวางเส้นทาง แต่ยังเป็นโมเดลวิจัยไม่ใช่คนขับ
อ่านสถาปัตยกรรมหัวรับรู้และ Planning Expert พร้อมเส้นแบ่งระหว่างผล benchmark กับความปลอดภัยบนถนนจริง
ลายน้ำข้อความของ Claude บอกได้แค่ความน่าจะเป็น ไม่ใช่ตราประทับว่าใครเขียน
Anthropic อัปเดต detection API และอธิบายข้อจำกัดของข้อความสั้น งานพิสูจน์อักษร โค้ด และการแก้ซ้ำ
Meta Muse Spark 1.3 ขึ้นโมเดลแนะนำบน Model API — โค้ดกับเอเจนต์ยาวขึ้น
สรุป Muse Spark 1.3 จากเอกสารนักพัฒนา Meta: โมเดลแนะนำใหม่ ราคา Standard/Contributor และสิ่งที่ทีมควรเช็กก่อนสลับจาก 1.2
Claude Fable 5.1 กับ Mythos 5.1: โมเดลเดียวกัน แต่สิทธิ์และ Safeguard คนละชั้น
อ่านประกาศ Claude รุ่นใหม่ผ่านมุม capability, cost, privacy และ access control แทนการดู benchmark เพียงตัวเดียว
ChatGPT for Healthcare ต่อ Epic และข้อมูลทางการ: Source-Connected ไม่เท่ากับเชื่อได้ทันที
วิเคราะห์ EHR integration และ Healthcare Public Data plugin ผ่าน consent, provenance, least privilege และ human review
DeepSeek V4 Pro ให้เลือก Reasoning Effort: งานไหนใช้ Low, High หรือ Max
แปลงฟีเจอร์ reasoning effort และราคา off-peak ของ DeepSeek V4 Pro เป็น routing policy ที่คุมคุณภาพ เวลา และต้นทุนได้
ยิ่งโมเดลเก่ง ยิ่งต้องถอดของออก: เมื่อ harness ของ AI Agent บวมเกินจำเป็น
ถอดสองเคสจริงของ Guy Erez ทั้ง PR 13 ไฟล์ที่ถูกปิดทิ้ง และ agent on-call ที่กิน cache-read token 2.1 พันล้าน คิดเป็นมูลค่าการใช้งานราว $1,050 พร้อมวิธีวัดว่าชิ้นไหนใน harness ยังคุ้มกับโมเดลรุ่นนี้