Jev Workshop #1: รู้จัก Jev โมเดลที่ไม่พูดสักคำ แต่ตอบเป็น type ให้โค้ดใช้ต่อได้ทันที
ร้านเสื้อผ้าออนไลน์ร้านหนึ่งมีบอทตอบแชท LINE ที่เขียนด้วย LLM ตอบคล่อง สุภาพ แต่บางวันก็เผลอสัญญากับลูกค้าว่า “พรุ่งนี้ของถึงแน่นอนค่ะ” ทั้งที่ร้านไม่เคยรับประกันวันส่ง คนที่ต้องไปขอโทษลูกค้าตอนของไม่มาคือแอดมินตัวจริงครับ
workshop ชุดนี้เราจะสร้าง “ด่านตรวจ” ให้บอทตอบแชท โดยใช้ Jev โมเดลใหม่จาก TypeSafe AI ที่ Vercel ประกาศให้ใช้ผ่าน AI Gateway เมื่อ 16 กันยายน 2026 ตอนจบเราจะมี:
- ตัวคัดแยกแชทลูกค้าที่รู้ตัวว่า “ไม่แน่ใจ” แล้วส่งให้คนดู (บทที่ 2)
- ตัวตรวจคำตอบของบอทก่อนส่งถึงลูกค้า (บทที่ 3)
- ด่านตรวจใน CI ที่ไม่ยอมให้ prompt ใหม่ขึ้น production ถ้าคุณภาพตก และตารางเทียบโมเดลถูก-แพงแบบคุ้มต่อบาท (บทที่ 4)
โค้ดทั้งหมดอยู่ใน repo `showkhun-jev-workshop` แต่ละบทมี branch ของตัวเอง บทนี้คือ step-01
เป้าหมายของบทนี้
ถาม Jev สามคำถามเกี่ยวกับข้อความลูกค้าภาษาไทยหนึ่งข้อความ แล้วได้คำตอบกลับมาเป็นข้อมูลที่ TypeScript ใช้ต่อได้ทันที ไม่ต้อง parse ข้อความ ไม่ต้องลุ้นว่า JSON จะมาครบไหม
node --experimental-strip-types src/01-first-eval.tsJev คืออะไร ในสามบรรทัด
- Jev เป็นสิ่งที่ TypeSafe เรียกว่า System One model ชื่อยืมมาจากแนวคิดของ Kahneman เรื่องความคิดแบบเร็วและตามสัญชาตญาณ (System 1) เทียบกับความคิดแบบช้าและไตร่ตรอง (System 2) (Vercel: What is Jev)
- มันไม่เขียนข้อความเลย ใส่ “สถานะ” (state) เข้าไป แล้วถามคำถามที่เรากำหนดคำตอบไว้ล่วงหน้า มันตอบกลับเป็น type สามแบบ: Choice (เลือกหนึ่งตัวเลือก), Score (ให้คะแนนตามขั้นบันไดที่เรานิยาม), Boolean (ความน่าจะเป็นที่ข้อความนั้น “จริง”) (Vercel Docs: Evaluation)
- ทุกคำถามถูกประเมิน พร้อมกันในรอบเดียว แทนที่จะพิมพ์ทีละ token แบบ LLM (changelog)
เปรียบเทียบแบบบ้านๆ: LLM เหมือนพนักงานรับโทรศัพท์ที่เล่าเรื่องยาวๆ แล้วเราต้องจดเองว่าลูกค้าอยากได้อะไร ส่วน Jev เหมือน ใบคิวธนาคาร ที่มีช่องให้ติ๊กแค่ “ฝาก / ถอน / ติดต่อเจ้าหน้าที่” พร้อมเขียนว่ามั่นใจแค่ไหน ใบคิวเล่านิทานไม่เป็น แต่ส่งต่อให้เคาน์เตอร์ถูกช่องได้ไวมาก
อีกมุมที่ The Register เล่าไว้: TypeSafe โชว์ว่า Jev เล่นเกม Doom ได้ถ้าป้อนสถานะเกมเป็นข้อมูลโครงสร้าง ส่วนงานจริงที่น่าจะได้ใช้คือคัดแยกเรื่องของฝ่ายบริการลูกค้า ซึ่งตรงกับ workshop เราพอดี (ร้านเสื้อผ้าเราไม่มีปีศาจให้ยิง มีแต่พัสดุหาย)
Jev ต่างจาก structured output ของ LLM ยังไง
prototype ของผมก่อนหน้านี้ใช้ generateText กับ Output.object ให้ LLM ตอบเป็น JSON ตาม zod schema ก็ใช้ได้ แต่มีสามเรื่องที่ Jev ต่าง:
| LLM + structured output | Jev | |
|---|---|---|
| วิธีได้คำตอบ | สร้างข้อความ JSON ทีละ token แล้ว validate | คืน type + ความน่าจะเป็นโดยตรง |
| ความน่าจะเป็นของแต่ละตัวเลือก | ไม่มีในตัว (ต้องขอให้โมเดล “เดา” เอง) | Choice/Score คืน distribution มาด้วย |
| ค่าบริการ | จ่ายทั้ง input และ output token | จ่าย input token อย่างเดียว |
ตัวเลขราคาที่ Vercel KB guide ระบุคือ $0.042 ต่อ 1 ล้าน input token และไม่คิด output ตรงกับที่ The Register รายงาน และตรงกับ catalog GET /v1/models ที่ผมเปิดดูเมื่อ 26 ก.ย. 2026
ติดตั้ง
ต้องใช้ Node 22 ขึ้นไป (AI SDK 7 เป็น ESM และต้องการ Node 22+) กับ AI Gateway API key
git clone https://github.com/kangana1024/showkhun-jev-workshop.git
cd showkhun-jev-workshop && git checkout step-01
pnpm install
export AI_GATEWAY_API_KEY="วาง key ของคุณ (อย่า commit)"
repo pin [email protected] ไว้ เพราะ AI SDK บอกตรงๆ ว่า experimental_evaluate “ยังเป็น experimental และอาจเปลี่ยนใน patch release” เวลาอัปเดตแพ็กเกจให้รันเทสทุกครั้ง
คำถามแรก: สามคำถามในรอบเดียว
ด้านล่างเป็นตัวอย่างโค้ดบางส่วนจาก src/01-first-eval.ts (ตัด import และส่วนพิมพ์ผลออก ไฟล์เต็มอยู่ใน branch step-01) เป็น fragment เพราะต้องต่อ network และใช้ key จึงรันใน verifier ของบล็อกไม่ได้
const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: { channel: 'LINE OA', message },
  questions: {
    route: {
      type: 'choice',
      instructions: 'Which queue should handle this Thai customer message?',
      criteria: {
        shipping: 'late, lost or wrong deliveries; tracking questions',
        refund: 'the customer asks for money back or to return an item',
        product: 'size, colour, material or defect questions before or after buying',
        store_info: 'opening hours, branches, payment methods',
      },
    },
    wantsRefund: {
      type: 'boolean',
      instructions: 'Does the customer ask for money back, now or conditionally?',
    },
    urgency: {
      type: 'score',
      instructions: 'How urgent is this for the shop to answer?',
      criteria: ['can wait a day', 'answer today', 'answer within the hour: deadline or angry customer'],
    },
  },
  providerOptions: { gateway: { tags: ['workshop:jev', 'step:01'] } },
});
สังเกตสามเรื่อง:
stateเป็น object ได้เลย ไม่ต้องJSON.stringifyเอง (Docs: Structured state)criteriaของ Choice คือ คำอธิบาย ไม่ใช่แค่ชื่อ ยิ่งอธิบายชัด ยิ่งมีอะไรให้โมเดลเทียบ (KB guide: Describe options and levels)tagsเป็น option ของ AI Gateway ช่วยให้แยกค่าใช้จ่ายตาม feature ได้ในรายงาน เดี๋ยวบทที่ 4 จะใช้จริง
ข้อความลูกค้าที่ใช้ทดสอบคือ “สั่งเสื้อไปตั้งแต่วันจันทร์ ยังไม่ได้ของเลยค่ะ เลขออเดอร์ #A1029 ถ้าไม่ทันวันเสาร์ขอคืนเงินนะคะ” ตั้งใจให้กำกวม: เป็นเรื่องส่งของ แต่มีการขอคืนเงินแบบมีเงื่อนไขซ้อนอยู่
รันดู (และเจอ 403 แรกของชีวิต)
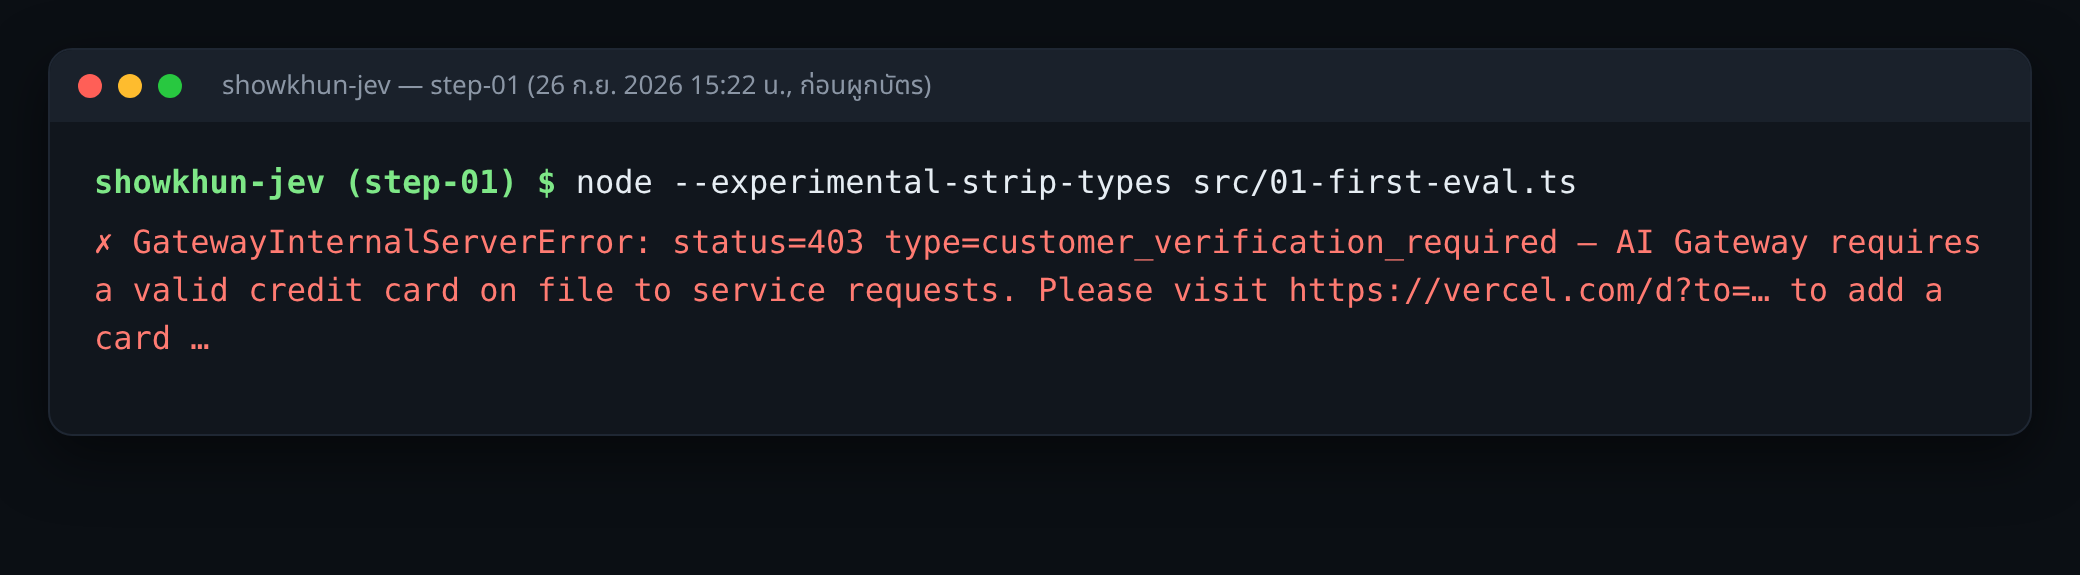
รอบแรกที่ผมรันจริงเมื่อ 26 ก.ย. 2026 เวลา 15:22 น. (เวลาไทย) ไม่ได้คำตอบจาก Jev ครับ ได้อันนี้แทน:
✗ GatewayInternalServerError: status=403 type=customer_verification_required — AI Gateway requires a valid credit card on file to service requests. Please visit https://vercel.com/d?to=... to add a card and unlock your free credits.นี่คือผลจริง ไม่ใช่ตัวอย่าง key ถูกต้องนะครับ (เรียก /v1/credits ได้ ยอดคงเหลือเป็น 0) แต่ FAQ ของ AI Gateway อธิบายว่า 403 ที่มี customer_verification_required แปลว่า ทีมต้องผูกบัตรก่อนถึงจะใช้เครดิตฟรีได้ ผูกบัตรที่หน้า AI Gateway ใน dashboard แล้วรันใหม่
มุกเล็กๆ ที่ต้องระวัง: AI SDK ห่อ error นี้เป็นคลาสชื่อ GatewayInternalServerError ทั้งที่จริงเป็น 403 ถ้าเขียน catch แล้วเช็กแค่ชื่อคลาส จะนึกว่าเซิร์ฟเวอร์ Vercel พัง ทั้งที่จริงแค่ยังไม่ผูกบัตร ใน repo ผมจึงเขียน explainError() ให้พิมพ์ statusCode กับ type จาก response body แทน
หลังผูกบัตร ผมรันคำสั่งเดิมอีกครั้งเมื่อ 26 ก.ย. 2026 เวลา 21:23 น. (เวลาไทย) คราวนี้ได้คำตอบจริง:
{
  "route": {
    "type": "choice",
    "choice": "shipping",
    "probabilities": {
      "product": 0,
      "refund": 0.28,
      "shipping": 0.72,
      "store_info": 0
    }
  },
  "wantsRefund": {
    "type": "boolean",
    "probability": 0.95
  },
  "urgency": {
    "type": "score",
    "score": 1.77,
    "probabilities": {
      "0": 0,
      "1": 0.23,
      "2": 0.77
    }
  }
}
confidence: {"route":0.63,"urgency":0.65}
usage: {"inputTokens":553,"outputTokens":80,"totalTokens":633}
provider=typesafe-ai generationId=gen_01M3F1KJ0EM8NQ01QE9GJR0R0W latency=400 ms (round trip from this machine)
1 calls, gateway.cost total $0.00002323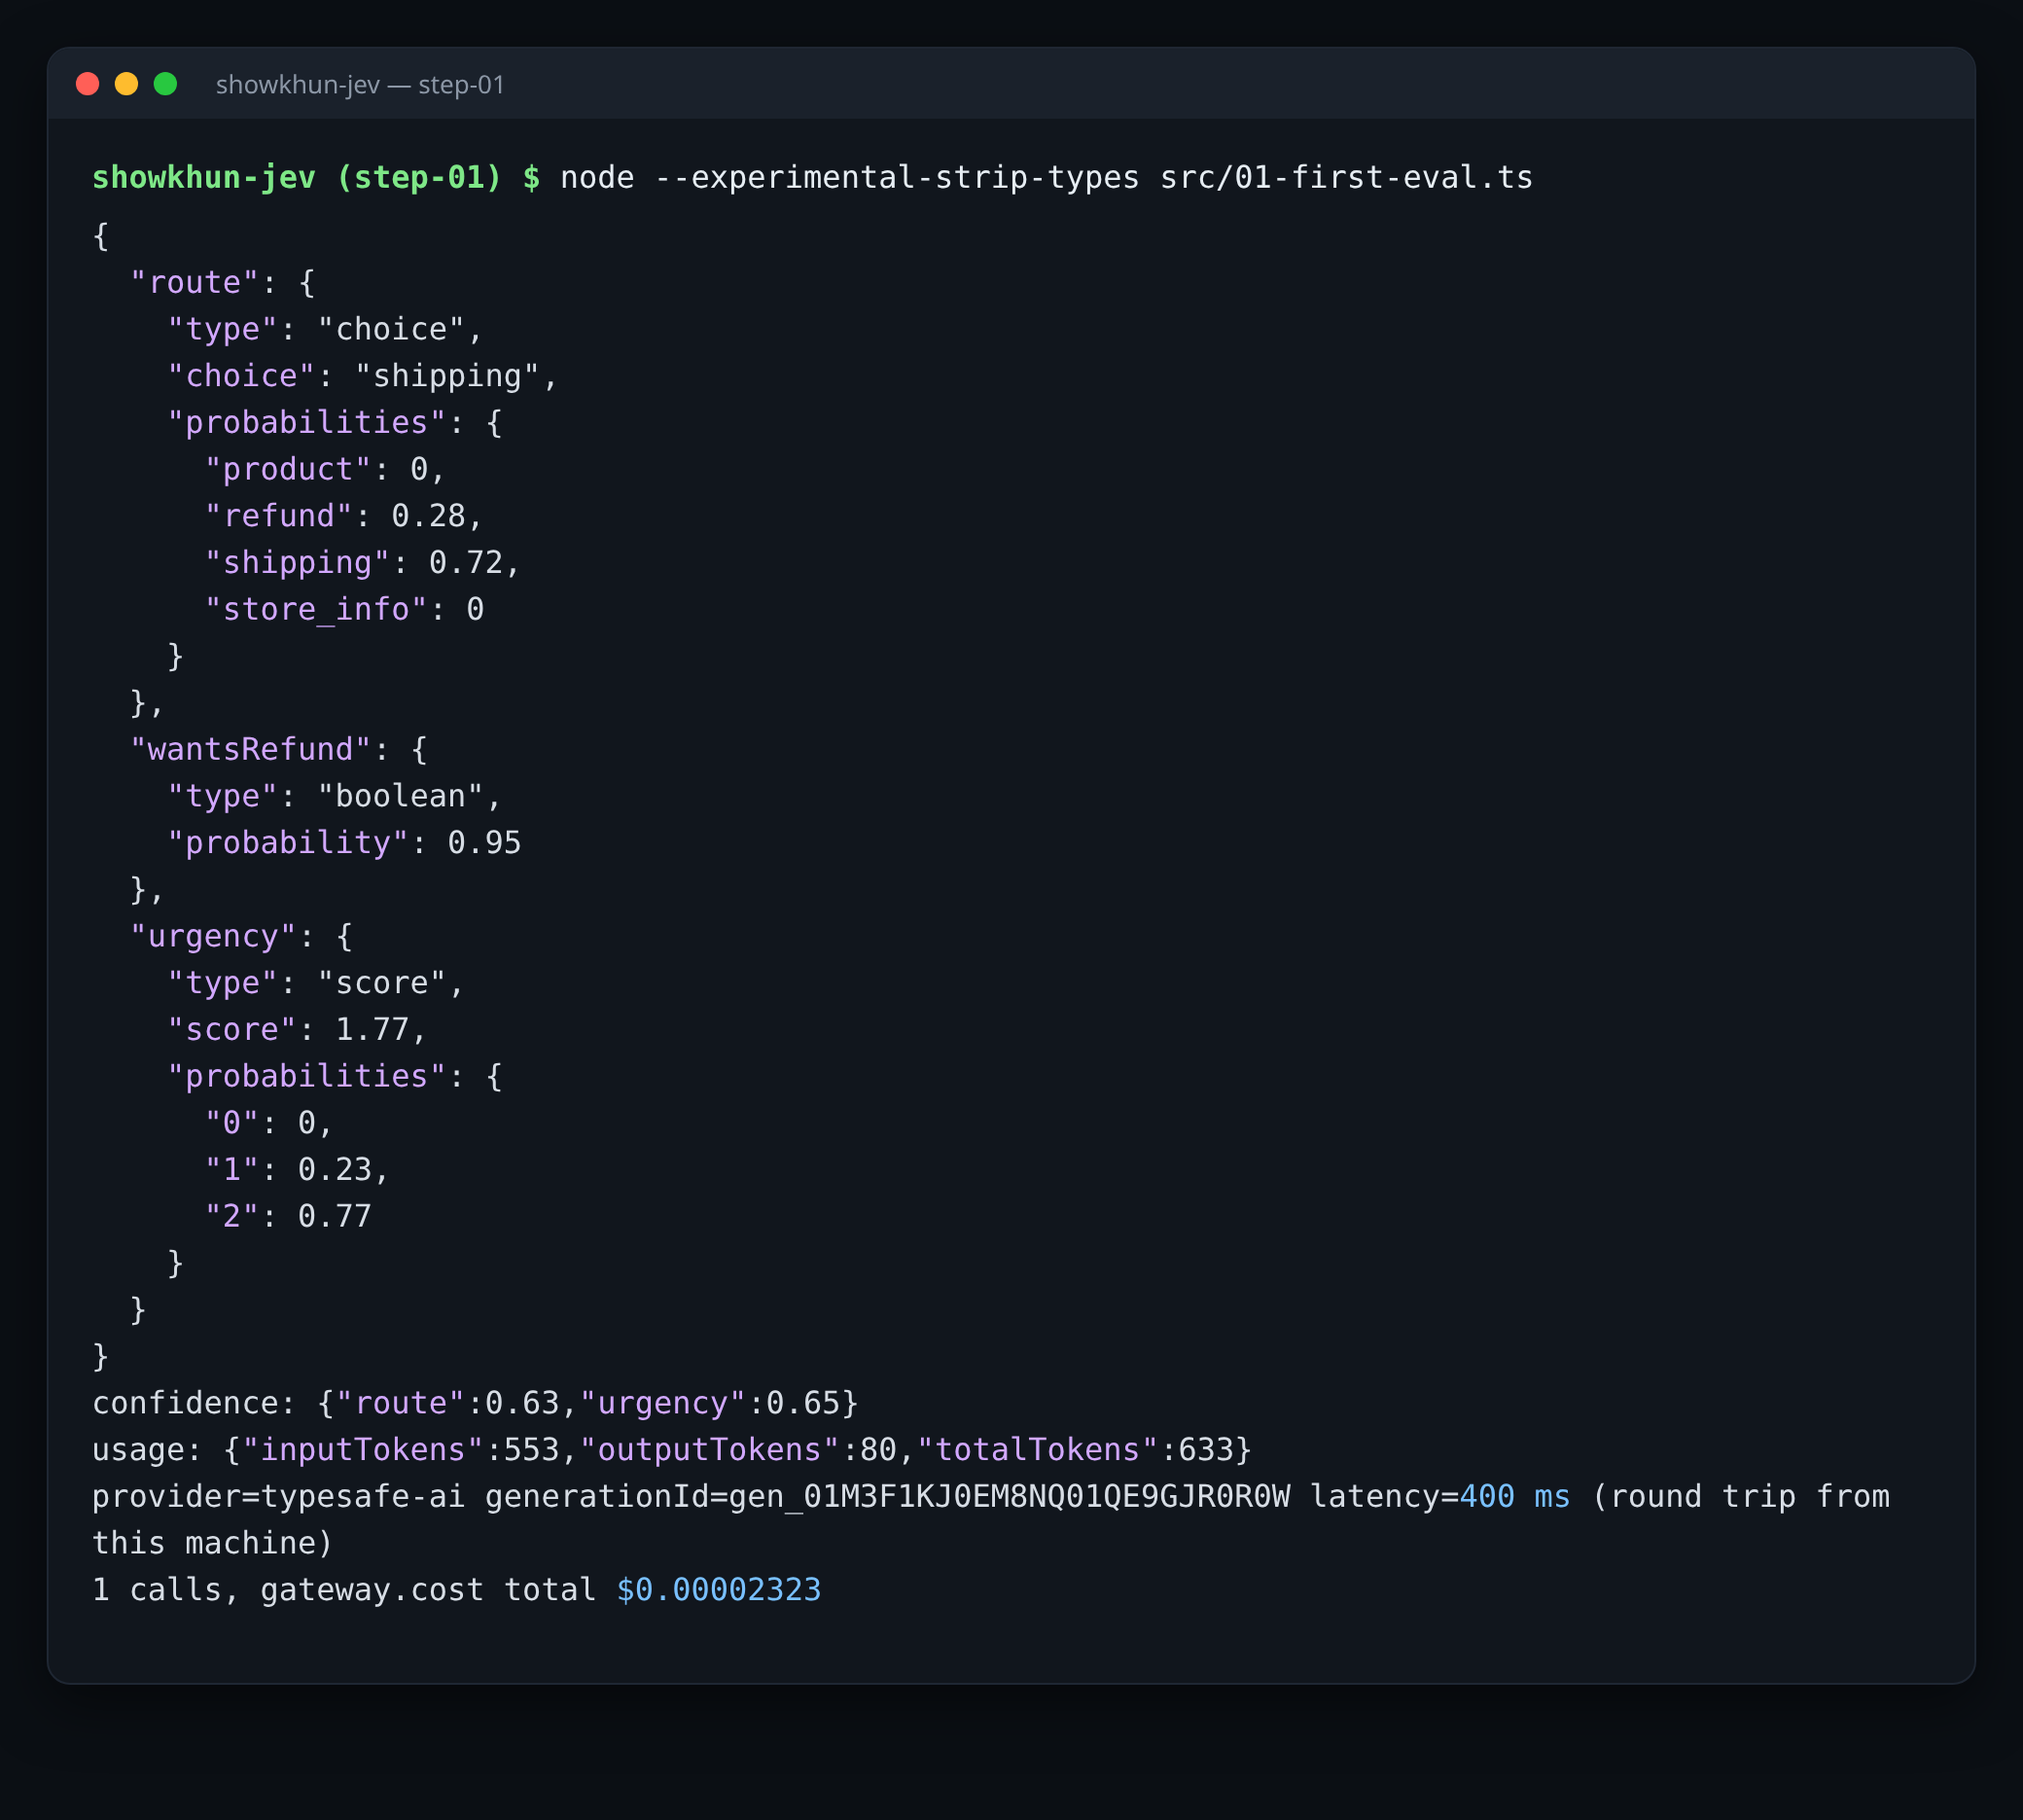
อ่านผลรอบนี้:
- route เลือก
shippingที่ 0.72 และให้refund0.28 ตรงกับที่ตั้งใจให้ข้อความกำกวม มันไม่ได้แกล้งมั่นใจ 100% แต่แบ่งน้ำหนักให้สองคิวที่เกี่ยวจริง ส่วนproductกับstore_infoได้ 0 - wantsRefund = 0.95 จับการขอคืนเงินแบบมีเงื่อนไข (“ถ้าไม่ทันวันเสาร์ขอคืนเงินนะคะ”) ได้ แม้ route จะเลือก shipping นี่คือเหตุผลที่ต้องแยกคำถามเป็นอะตอม บทหน้าเราจะใช้ข้อนี้ส่งเรื่องเงินให้คนเสมอ
- urgency = 1.77 จาก 0–2 (distribution 0.23 / 0.77) คือค่อนไปทาง “ตอบภายในชั่วโมง” เพราะมีเส้นตายวันเสาร์
- ใช้ 553 input token สำหรับข้อความสั้นๆ หนึ่งประโยคกับสามคำถาม มากกว่าตัวอย่างในเอกสาร (275) เกือบเท่าตัว เพราะคำถามและ criteria ของเราก็นับเป็น input ด้วย ค่าใช้จ่ายจริงคือ $0.00002323 ต่อ request (553 × $0.042/ล้าน ตรงตามราคา)
- latency ที่วัดจากเครื่องผม (กรุงเทพฯ ถึง AI Gateway ไปกลับ) คือ 400 ms ในรอบนี้ ส่วนใหญ่ของ request ใน workshop นี้อยู่ราว 200–500 ms แต่บทที่ 2 จะเห็นว่ามีช่วงที่ช้ากว่านั้นมาก
ตอนรันซ้ำด้วยข้อความเดิม ค่าบางตัวขยับได้เล็กน้อย เช่นใน 01-http.ts ด้านล่าง ผมได้ 0.81 รอบหนึ่งและ 0.82 อีกรอบ อย่าเขียนเทสที่คาดหวังเลขเป๊ะจากโมเดลจริง
อ่านคำตอบให้ถูก
ตามเอกสาร answers แต่ละตัวมี type ตรงกับคำถาม (AI SDK: Question types):
- Choice คืน
choice(ชื่อตัวเลือก) และอาจมีprobabilitiesของทุกตัวเลือก - Score คืน
scoreเป็นทศนิยมในช่วง 0 ถึง (จำนวนขั้น − 1) เช่น 3 ขั้นก็ 0–2 - Boolean คืน
probabilityของกรณี “จริง” เสมอ
ตัวอย่างจากเอกสาร Vercel (ไม่ใช่ผลของเรา) หน้าตาแบบนี้:
{
  "route": {
    "type": "choice",
    "choice": "billing",
    "probabilities": { "billing": 1, "shipping": 0, "technical": 0 }
  }
}
สองเรื่องที่คนพลาดบ่อย:
- Boolean 0.02 ไม่ได้แปลว่า “ไม่แน่ใจ” แต่แปลว่า “ค่อนข้างมั่นใจว่าไม่จริง” ความไม่แน่ใจสูงสุดอยู่แถว 0.5 (Vercel: probabilities and thresholds)
- Score 2.4 จาก 3 ขั้น ไม่ใช่ความน่าจะเป็น 80% มันคือ “ตำแหน่ง” บนบันไดที่เรานิยาม หารให้เป็น 0–1 ได้ แต่ความหมายไม่เปลี่ยน (หน้าเดียวกัน)
ส่วน result.providerMetadata.typesafe.confidence เป็นค่าเฉพาะของ TypeSafe บอก “ความกระจุก” ของ distribution ไม่ใช่ความน่าจะเป็นที่คำตอบถูก ใช้เทียบข้ามโมเดลไม่ได้
ถูกแค่ไหน: ตัวเลขจริงจากบิลของเรา
ตอนเขียนร่างแรกผมคิดเงินจากตัวอย่างในเอกสาร (275 input token) แล้วคาดว่า Jev จะถูกกว่า LLM ราคาถูกราว 3 เท่า ผลรันจริงไม่เป็นแบบนั้นครับ โค้ดด้านล่างรันได้ไม่ต้องใช้ key ใช้ gateway.cost ที่วัดได้จริงในบทที่ 2 (ข้อความลูกค้าชุดเดียวกัน 16 ข้อความ, 26 ก.ย. 2026)
// gateway.cost รวมที่วัดได้จริงในบทที่ 2 (26 ก.ย. 2026) หน่วย USD
// Jev: 3 คำถาม (route, wantsRefund, upset) 14 request ที่สำเร็จ
const jevPerCall = 0.00027728 / 14;
// gemini-2.5-flash-lite + Output.object (queue, needsHuman) 16 request
const llmPerCall = 0.0001625 / 16;

for (const n of [1_000, 100_000]) {
  console.log(`${n.toLocaleString()} แชท: Jev $${(jevPerCall * n).toFixed(4)} | flash-lite $${(llmPerCall * n).toFixed(4)}`);
}
console.log(`Jev แพงกว่าต่อแชท ≈ ${(jevPerCall / llmPerCall).toFixed(1)} เท่า ในการตั้งค่าของ workshop นี้`);
ทำไมเป็นแบบนี้: Jev คิดเงินแค่ input ก็จริง แต่ คำถาม คำอธิบาย criteria และ state ทั้งหมดคือ input ในการรันจริง request ของ Jev ใช้ราว 450–560 input token ต่อสามคำถาม (คำถามเดียวแบบ 01-http.ts ยังใช้ 312) ขณะที่ prompt ของ LLM baseline สั้นแค่บรรทัดเดียว ต่อให้ LLM คิดค่า output ด้วยก็ยังถูกกว่า ทั้งสองแบบยังถูกมาก (ราว $0.00001–0.00002 ต่อแชท หรือไม่ถึง 0.1 สตางค์) แต่คำอ้างว่า “ถูกกว่าหลายร้อยเท่า” ของผู้ผลิต ไม่เกิดกับงานแบบของเรา จุดที่ Jev ชนะจริงคือ distribution ที่เอาไปตั้ง threshold ได้ และ latency กลางๆ ที่ต่ำกว่า (ดูบทที่ 2)
คูณเรทบาทของวันนั้นเอาเองนะครับ ผมไม่ใส่เรทตายตัวในบทความ เดี๋ยวอ่านปีหน้าแล้วงง ส่วน Vercel ใส่ ค่าใช้จ่ายจริงของทุก request ไว้ใน providerMetadata.gateway.cost (Docs: HTTP API response) บทที่ 4 เราจะรวมตัวเลขนี้เป็นรายงาน
ไม่ใช้ AI SDK ก็ได้: POST /v1/evaluate
ทีมที่ backend เป็นภาษาอื่นเรียก HTTP ตรงได้ ด้านล่างเป็นตัวอย่างโค้ดบางส่วนจาก src/01-http.ts (fragment เพราะต้องต่อ network)
const res = await fetch('https://ai-gateway.vercel.sh/v1/evaluate', {
  method: 'POST',
  headers: { Authorization: `Bearer ${process.env.AI_GATEWAY_API_KEY}`, 'Content-Type': 'application/json' },
  body: JSON.stringify({
    model: 'typesafe-ai/jev',
    state: 'โดนตัดเงินสองรอบสำหรับออเดอร์เดียวครับ',
    questions: { refund: { type: 'boolean', instructions: 'Is the customer asking for money back?' } },
  }),
});
ข้อควรรู้: เอกสารระบุ ว่า evaluation ใช้ผ่าน endpoint แบบ OpenAI-compatible ไม่ได้ ต้องใช้ AI SDK 7, /v1/evaluate หรือ TypeSafe-compatible API เท่านั้น ใครคิดจะเอา OpenAI SDK ตัวเดิมมาเปลี่ยน base URL แล้วเรียก Jev ขอให้พักความคิดนั้นไว้ก่อน
ผลรันจริง (26 ก.ย. 2026 21:23 น.):
HTTP 200 in 470 ms
{
  "answers": {
    "refund": {
      "type": "boolean",
      "probability": 0.82
    }
  },
  "usage": {
    "inputTokens": 312,
    "outputTokens": 20
  },
  "cost": "0.000013104"
}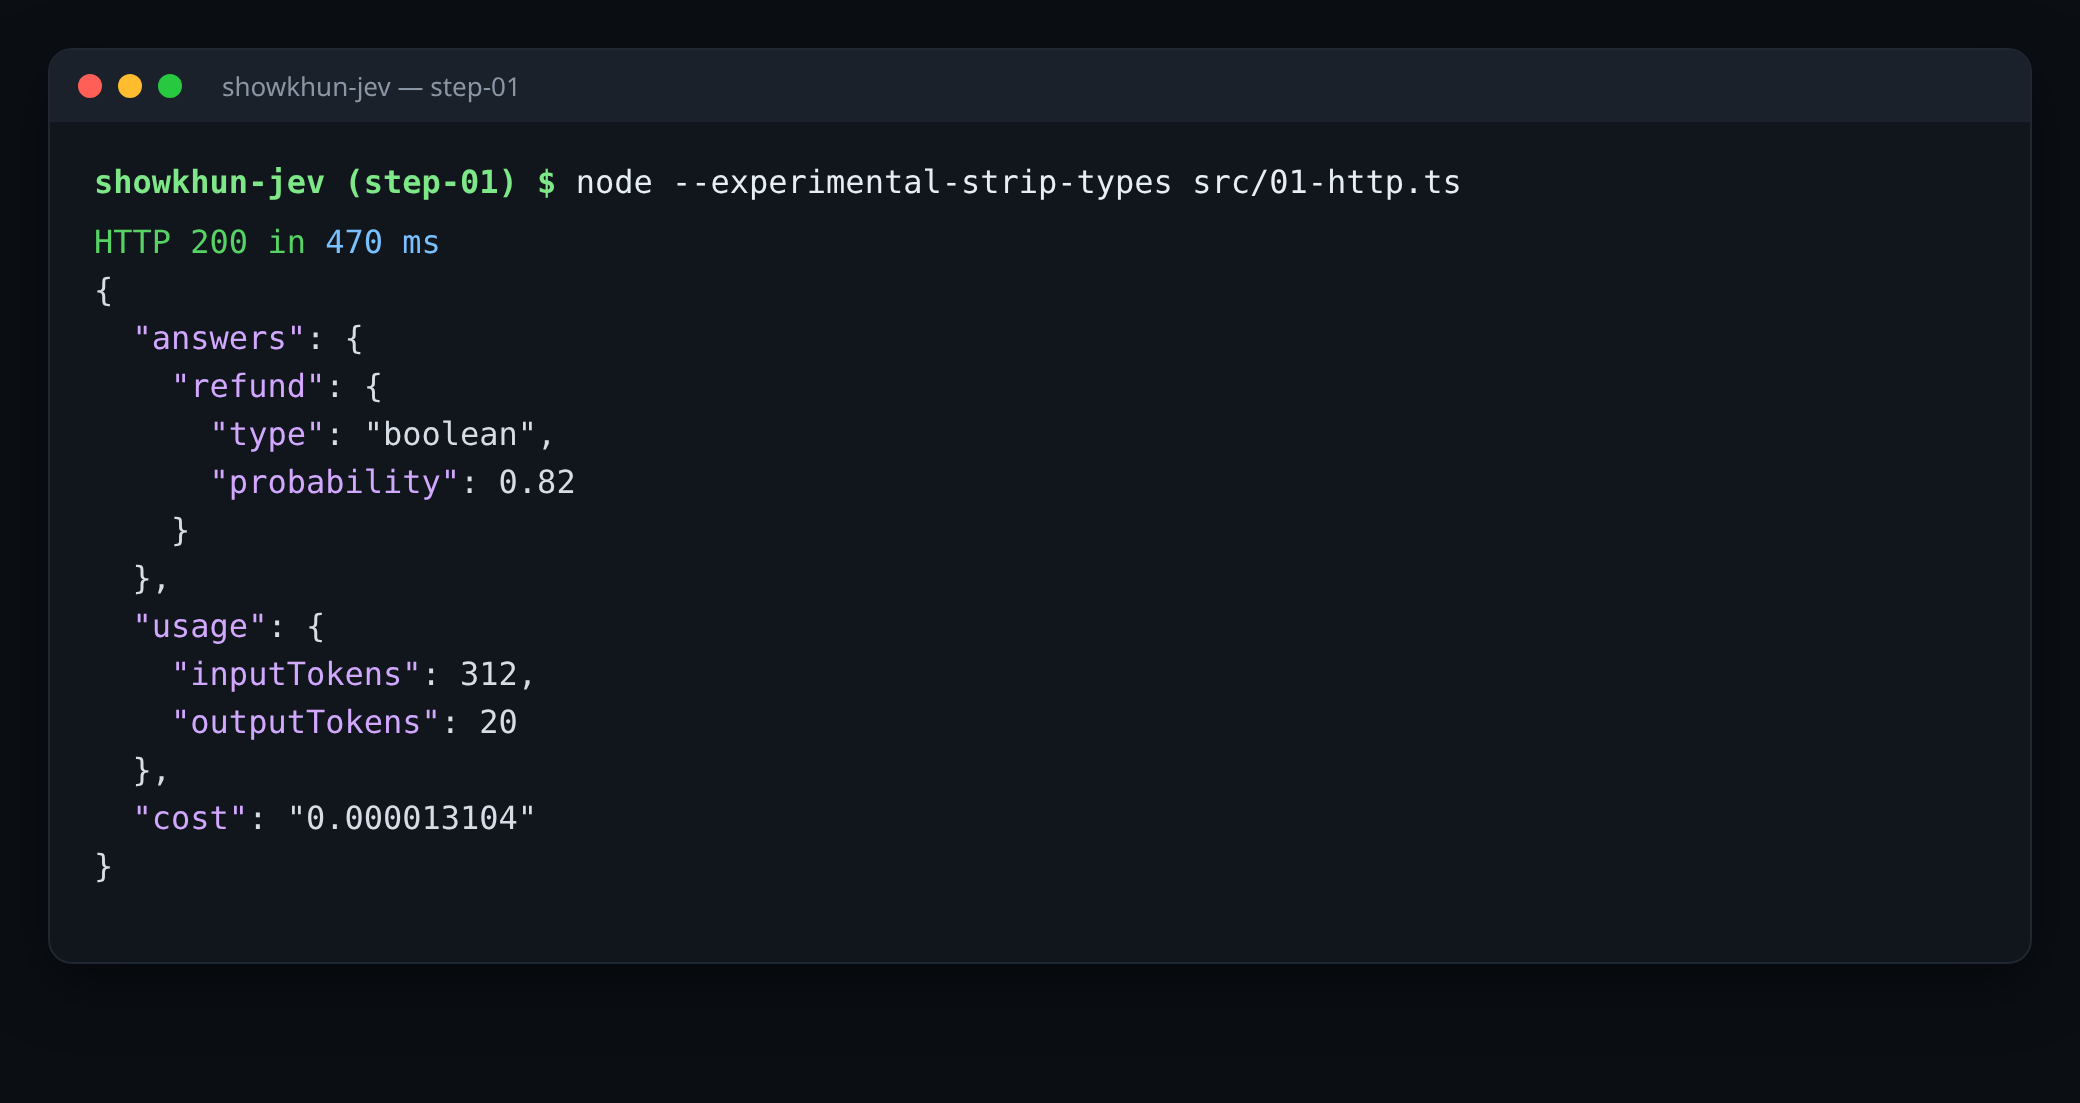
“โดนตัดเงินสองรอบ” ไม่ได้เขียนคำว่า “ขอเงินคืน” ตรงๆ แต่ Jev ให้ 0.82 ว่าลูกค้ากำลังขอเงินคืน สมเหตุสมผล (ผมรันคำขอนี้สองครั้ง ได้ 0.81 และ 0.82) คำถามเดียวใช้ 312 input token ค่าใช้จ่าย $0.000013104 ตรงกับ 312 × $0.042/ล้าน พอดี ส่วน outputTokens: 20 มีรายงานมาแต่ไม่ถูกคิดเงิน
ข้อมูลที่ยังไม่ชัด และจุดที่แหล่งพูดไม่ตรงกัน
- ชื่อโมเดล: เอกสาร AI Gateway และ catalog ใช้
typesafe-ai/jevแต่ตัวอย่างใน เอกสาร AI SDK ใช้typesafe-ai/jev-latestผมลองเรียกจริงเมื่อ 26 ก.ย. 2026:typesafe-ai/jevได้ 200 ส่วนtypesafe-ai/jev-latestและjev-latestได้404 model_not_foundทั้งคู่ บน AI Gateway ให้ใช้typesafe-ai/jev - ตัวเลขความเร็ว/ความถูก: changelog ของ Vercel อ้างว่า TypeSafe รายงาน “เร็วกว่าสูงสุด 193.6 เท่า ถูกกว่า 444.6 เท่า” บน workflow ของ TypeSafe เอง ส่วน The Register รายงานคำอ้างของ TypeSafe ว่าตอบใน 70–500 ms “เร็วกว่า 40–200 เท่า” ทั้งหมดเป็น ตัวเลขที่ผู้ผลิตรายงานเอง ที่เราวัดเองคือ round trip จากกรุงเทพฯ ส่วนใหญ่ 200–500 ms (median 401 ms ในบทที่ 2) แต่ช่วงที่ผู้ให้บริการต้นทางคนใช้เยอะ เจอ rate limit จน request ช้าถึง ~59 วินาที หรือล้มหลัง retry 3 ครั้ง ส่วนเรื่องค่าใช้จ่าย ในงานของเรา Jev แพงกว่า flash-lite ราว 2 เท่าต่อแชท (หัวข้อ “ถูกแค่ไหน” ด้านบน)
- “ไม่ hallucinate”: TypeSafe เขียนว่า Jev “can’t hallucinate” แต่ Vercel เองย้ำ ว่า type ถูกไม่ได้แปลว่าคำตอบถูก และ The Register ชี้ว่าคำตอบแบบมีโครงสร้าง “ก็ยังผิดได้” สรุปคือ มันตอบนอกกรอบไม่ได้ แต่เลือกช่องผิดได้
- ภาษาไทย: ไม่มีแหล่งไหนที่ผมอ่านพูดถึงการรองรับภาษาไทยเลย (ยังไม่มีคำยืนยันอย่างเป็นทางการ) แต่ผลทดสอบของเราเอง Jev อ่านข้อความไทยได้สมเหตุสมผล: คัดแยก 16 ข้อความไทยที่ติดป้ายไว้ถูกครบ 16 ข้อ (บทที่ 2) จับประชดประชันและการปฏิเสธ (“ไม่ได้อยากได้เงินคืน”) ได้ถูก ชุดทดสอบยังเล็กมาก ถือเป็นหลักฐานเบื้องต้น ไม่ใช่การรับรอง
- Zero Data Retention: changelog บอกว่ารองรับ ZDR แบบต่อ request แต่ข้อมูล catalog ที่ผมดึงมาแสดง
zdr: "none"ใครต้องใช้ ZDR จริงให้ทดสอบzeroDataRetention: trueแล้วดูใน logs ก่อน
สรุปบทนี้
- Jev ไม่สร้างข้อความ ตอบเป็น Choice / Score / Boolean พร้อมความน่าจะเป็น เหมาะกับการคัดแยกและตรวจงาน
- เรียกผ่าน AI Gateway ได้สามทาง:
experimental_evaluateของ AI SDK 7,POST /v1/evaluateและ TypeSafe-compatible API ไม่ใช่ OpenAI-compatible endpoint - ราคา $0.042 ต่อล้าน input token ไม่คิด output แต่คำถามและ criteria นับเป็น input ด้วย สามคำถามของเราใช้ 553 token ($0.00002323) ตัวเลขจริงต่อ request อยู่ใน
providerMetadata.gateway.cost - 403
customer_verification_required= ยังไม่ผูกบัตร อย่าเชื่อชื่อคลาส error ให้ดู status กับ type
บทหน้าเราจะเอาข้อความลูกค้าไทย 16 ข้อความที่ติดป้ายคำตอบเองมาวัดว่า Jev คัดแยกถูกแค่ไหน และตั้งเกณฑ์ว่าเมื่อไหร่ต้องส่งให้คนดู
Recap
- ติดตั้ง Node 22+, pnpm และ clone branch
step-01 - ผูกบัตรในทีม Vercel แล้ว (ไม่งั้นเจอ 403)
- รัน
01-first-eval.tsได้ answers ครบสามคำถาม - อธิบายได้ว่า Boolean 0.02 กับ 0.5 ต่างกันยังไง
- รู้ว่า Score ไม่ใช่ความน่าจะเป็น
- เห็น
gateway.costของ request ตัวเอง