Jev Workshop #2: คัดแยกแชทลูกค้าด้วยความน่าจะเป็น และรู้ว่าเมื่อไหร่ต้องส่งให้คน
ร้านข้าวมันไก่ที่ขายดีมีกฎง่ายๆ: ลูกค้าสั่ง “ธรรมดา” แม่ครัวทำเลยไม่ต้องถาม แต่ถ้าลูกค้าพูดว่า “เอาแบบเมื่อวานนะ” แม่ครัวจะหันไปถามเจ้าของร้านก่อน นั่นแหละครับคือ threshold ที่เราจะสร้างในบทนี้: มั่นใจพอก็ทำเลย ไม่มั่นใจก็ส่งให้คน
บทที่แล้วเราถาม Jev ได้แล้ว บทนี้จะเอาคำตอบไปตัดสินใจจริง พร้อมวัดผลกับข้อมูลที่รู้คำตอบอยู่แล้ว เพราะ Vercel ย้ำ ว่าความน่าจะเป็นสูงก็ยังต้องวัดกับข้อมูลของเราเองก่อนเชื่อ
เป้าหมายของบทนี้
git checkout step-02
pnpm test                                               # ไม่ต้องใช้ key
node --experimental-strip-types src/02-route-dataset.ts # เรียก Jev จริง 16 ครั้ง
node --experimental-strip-types src/02-llm-baseline.ts  # LLM ตัวเดิม 16 ครั้ง ไว้เทียบ
ตอนจบบทเราจะได้ฟังก์ชัน decide() ที่ตอบได้สามแบบ: ส่งเข้าคิวอัตโนมัติ, ส่งให้คนเพราะเกี่ยวกับเงิน, หรือส่งให้คนเพราะ Jev ไม่มั่นใจพอ พร้อมตารางว่าเกณฑ์แต่ละระดับทำให้งานคนเพิ่มขึ้นเท่าไหร่
ข้อมูลทดสอบ: 16 ข้อความที่เราติดป้ายเอง
ไฟล์ data/tickets.ts มีข้อความลูกค้าไทย 16 ข้อความ ผมเขียนและติดป้ายคำตอบเองด้วยมือ ไม่ได้ให้โมเดลติดป้าย เพราะ คำแนะนำของ Vercel บอกว่าอย่าเอา “การยอมรับคำแนะนำของโมเดล” มาใช้เป็นป้ายคำตอบ มีทั้งข้อความชัดๆ อย่าง “ร้านเปิดกี่โมงคะ” และข้อความกำกวมที่ตั้งใจใส่ไว้ เช่น “ถ้าพรุ่งนี้ของยังไม่มา ขอยกเลิกและคืนเงินนะ” ซึ่งเป็นทั้งเรื่องส่งของและเรื่องเงิน
16 ข้อความนี้น้อยนะครับ พอสำหรับสอน แต่ไม่พอสำหรับตัดสินใจจริง หน้าเดียวกันของ Vercel แนะนำให้เก็บ “จำนวนเคส” ไว้คู่กับทุกเปอร์เซ็นต์ เพราะกลุ่มเล็กๆ ผิดเพิ่มแค่ข้อสองข้อ ตัวเลขก็แกว่งมาก
ถามคำถามแบบ “อะตอม”
KB guide ของ Vercel แนะนำให้ถามทีละเรื่องเล็กๆ แล้วเอาไปรวมในโค้ดเอง แทนที่จะถามว่า “เรื่องนี้ด่วนไหม” ทีเดียว เราจึงแยกเป็นสามคำถามใน src/questions.ts: เลือกคิว (Choice), ขอเงินคืนไหม (Boolean), ลูกค้าหงุดหงิดไหม (Boolean) ข้อดีอีกอย่างคือ เพิ่มคำถามไม่ทำให้คำตอบเดิมแย่ลง เพราะแต่ละข้อถูกประเมินแยกกัน
ตัดสินใจ: เกณฑ์ต่อ action ไม่ใช่ต่อโมเดล
หลักจาก KB guide: action ที่ย้อนกลับได้ (เช่น ส่งเข้าคิวผิด แล้วแอดมินย้ายเอง) ใช้เกณฑ์ต่ำได้ ส่วน action ที่เสียหายจริง (เช่น เรื่องเงิน) ต้องเกณฑ์สูงหรือส่งคนเสมอ และ อย่าให้ Jev เป็นคนอนุมัติ Jev บอกได้ว่าลูกค้า “ขอเงินคืน” แต่จะคืนหรือไม่คืนเป็นกฎของร้านที่ Jev ไม่รู้
โค้ดด้านล่างเป็นตรรกะเดียวกับ decide() ใน src/route.ts แต่ย่อให้รันเดี่ยวได้โดยไม่ต้อง import อะไร (verifier ของบล็อกรันจริงด้วย Bun)
type Answers = {
  route: { choice: string; probabilities?: Record<string, number> };
  wantsRefund: { probability: number };
  upset: { probability: number };
};

const POLICY = { minRouteProbability: 0.8, refundToHuman: 0.5, upsetToHuman: 0.7 };

function decide(a: Answers) {
  // distribution เป็น optional ตามสเปก AI SDK: ถ้าไม่มี ห้ามเดาเป็น 0 หรือ 1
  const p = a.route.probabilities?.[a.route.choice] ?? null;
  if (a.wantsRefund.probability >= POLICY.refundToHuman) return { action: 'human-review', reason: 'refund', p };
  if (a.upset.probability >= POLICY.upsetToHuman) return { action: 'human-review', reason: 'upset', p };
  if (p == null) return { action: 'human-review', reason: 'no-distribution', p };
  if (p < POLICY.minRouteProbability) return { action: 'human-review', reason: 'low-probability', p };
  return { action: 'assign', queue: a.route.choice, p };
}

// ค่าสมมติสำหรับสาธิต ไม่ใช่ผลจาก Jev
const cases: Answers[] = [
  { route: { choice: 'store_info', probabilities: { store_info: 0.95, shipping: 0.05 } }, wantsRefund: { probability: 0.01 }, upset: { probability: 0.02 } },
  { route: { choice: 'shipping', probabilities: { shipping: 0.9, refund: 0.1 } }, wantsRefund: { probability: 0.62 }, upset: { probability: 0.3 } },
  { route: { choice: 'shipping', probabilities: { shipping: 0.55, refund: 0.45 } }, wantsRefund: { probability: 0.2 }, upset: { probability: 0.1 } },
  { route: { choice: 'product' }, wantsRefund: { probability: 0.1 }, upset: { probability: 0.1 } },
];
for (const c of cases) console.log(JSON.stringify(decide(c)));
สังเกตบรรทัด ?? null ครับ เอกสาร AI SDK บอกว่า distribution ของ Choice และ Score เป็น optional ถ้าวันหนึ่งเราเปลี่ยนไปใช้โมเดลที่ไม่ส่ง distribution มา แล้วโค้ดแทนค่าเป็น 1 เงียบๆ บอทจะมั่นใจเกินเหตุทันที เหมือนแม่ครัวที่ไม่ได้ยินลูกค้าพูด แต่ทำเมนูไปก่อนเพราะคิดว่าคงสั่งธรรมดา
เทสแบบไม่ต้องต่อเน็ต: mock evaluation model
threshold เป็นตรรกะของแอปเรา จึงควรมีเทสเหมือนโค้ดอื่นๆ AI SDK มี Experimental_EvaluationMockModelV4 ใน ai/test ที่คืนคำตอบตามที่เรากำหนด (KB guide ขั้นที่ 5) ด้านล่างเป็นตัวอย่างโค้ดบางส่วนจาก test/route.test.ts (ตัด import ออก ต้องมี dependency ai จึงไม่รันใน verifier ของบล็อก)
const mock = (answers: Answers) =>
  new MockEvaluationModel({ doEvaluate: async () => ({ answers, warnings: [] }) });

test('refund always goes to a human, even when routing is confident', async () => {
  const { decision } = await routeMessage(
    'ขอคืนเงิน',
    mock({ ...clear, wantsRefund: { type: 'boolean', probability: 0.9 } }),
  );
  assert.equal(decision.action, 'human-review');
});
ผลรันจริงบนเครื่องผม (Node 22.23.2, ไม่ใช้ key):
# tests 5
# pass 5
# fail 0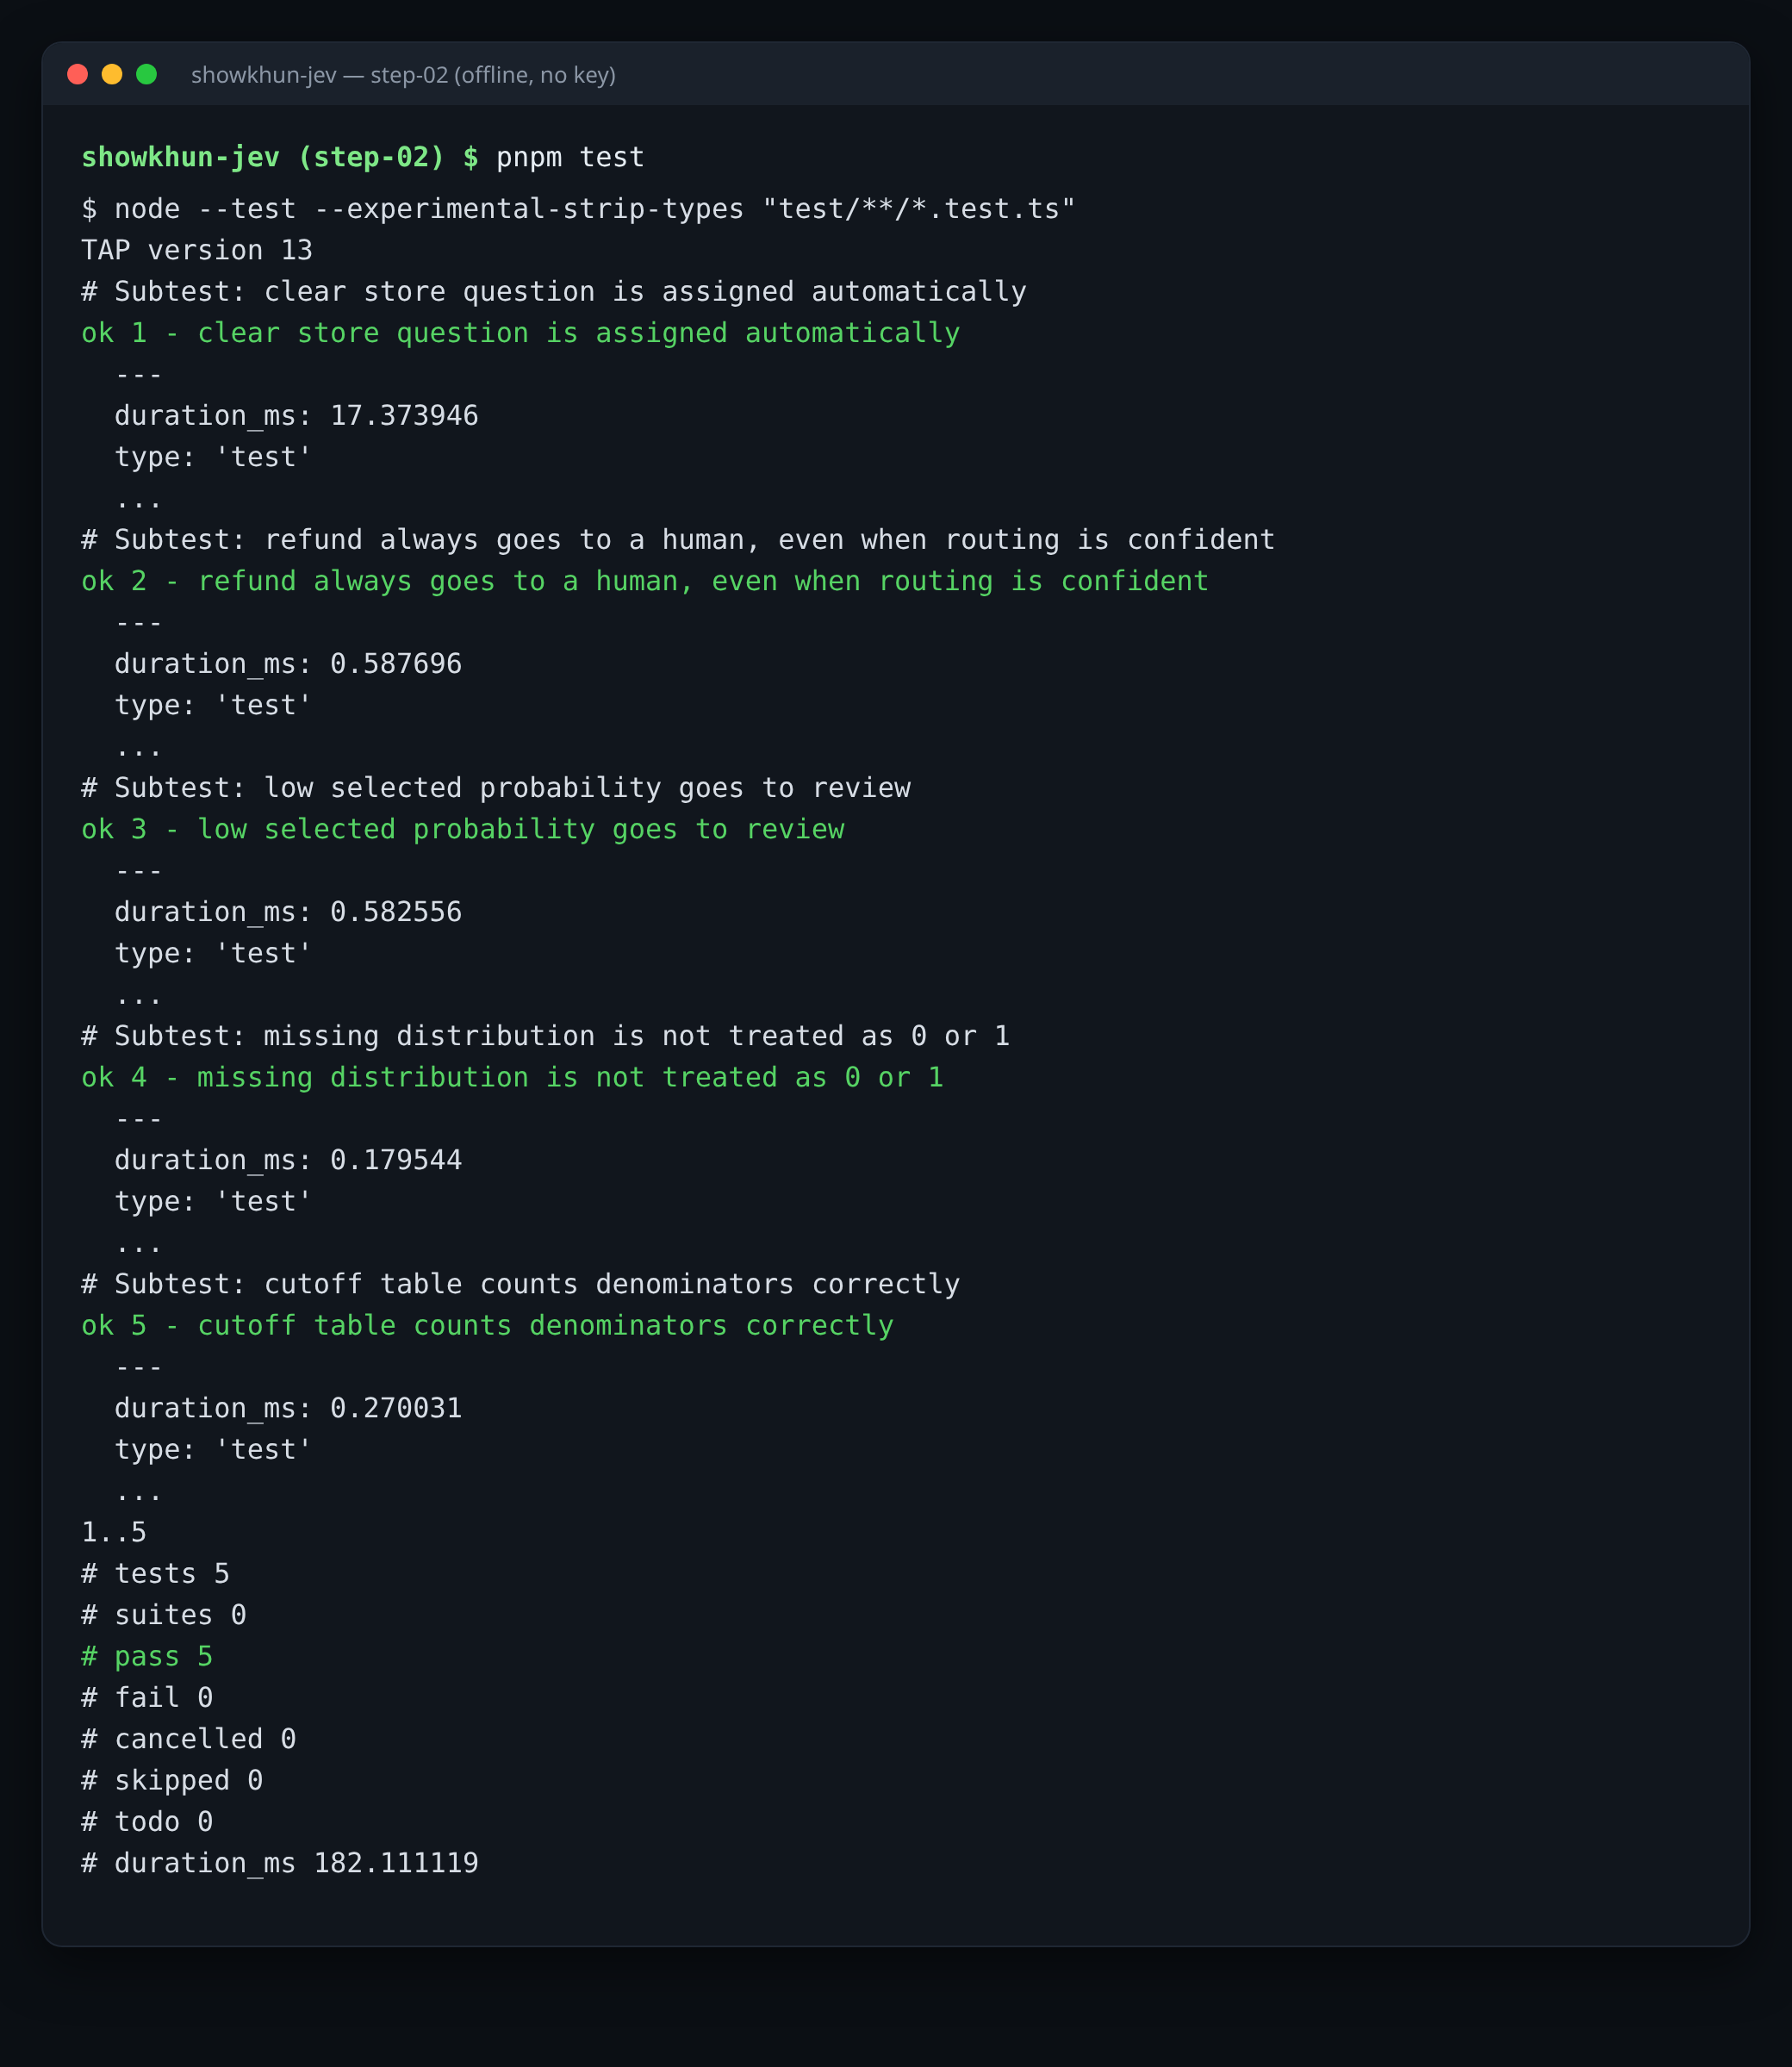
เทสผ่านแปลว่า โค้ดทำตามกฎที่เราเขียน ไม่ได้แปลว่า กฎถูกกับข้อมูลจริง อันหลังต้องวัดด้วยข้อมูลที่ติดป้าย ซึ่งคือหัวข้อถัดไป
รันกับ Jev จริง แล้วดูตารางเกณฑ์
src/02-route-dataset.ts วนส่ง 16 ข้อความให้ Jev แล้วคำนวณสองอย่าง: ความแม่นรวม และตารางว่าแต่ละเกณฑ์ (0.6 / 0.8 / 0.95) ส่งอัตโนมัติกี่ข้อ ส่งคนกี่ข้อ และผิดกี่ข้อ โดยนับตัวหารจากเฉพาะข้อที่ส่งอัตโนมัติ ตามที่ Vercel อธิบาย ว่า “ผิด 4 จาก 400 ข้อที่ส่งอัตโนมัติ” กับ “ผิด 4 จากทั้งหมด 1,000 ข้อ” เป็นคนละตัวชี้วัดกัน
ผลรันจริงเมื่อ 26 ก.ย. 2026 เวลา 21:24–21:27 น. (เวลาไทย) ไม่ได้ตัดแต่งอะไร รวมบรรทัดที่ล้มด้วย:
t01 expected=shipping jev=shipping p=1 → human-review(upset) 418ms
t02 expected=shipping jev=shipping p=1 → assign 274ms
t03 expected=shipping jev=shipping p=1 → human-review(upset) 210ms
t04 expected=shipping jev=shipping p=0.99 → assign 2549ms
t05 expected=refund jev=refund p=1 → human-review(refund) 391ms
t06 ✗ AI_RetryError: status=? type=? — Failed after 3 attempts. Last error: GatewayRateLimitError: The upstream provider is currently experiencing high demand. Please retry shortly.
t07 expected=refund jev=refund p=1 → human-review(refund) 44713ms
t08 expected=refund jev=refund p=1 → human-review(refund) 310ms
t09 expected=product jev=product p=1 → assign 269ms
t10 expected=product jev=product p=1 → assign 58600ms
t11 expected=product jev=product p=0.99 → human-review(upset) 360ms
t12 expected=product jev=product p=1 → assign 410ms
t13 expected=store_info jev=store_info p=1 → assign 470ms
t14 ✗ AI_RetryError: status=? type=? — Failed after 3 attempts. Last error: GatewayRateLimitError: The upstream provider is currently experiencing high demand. Please retry shortly.
t15 expected=store_info jev=store_info p=1 → assign 52574ms
t16 expected=refund jev=refund p=0.88 → human-review(refund) 349ms
accuracy=100.0% on 14/16 tickets, 175143 ms total, median 401 ms/request
{"cutoff":0.6,"automatic":14,"toReview":0,"wrongAutomatic":0,"errorRateAmongAutomatic":0}
{"cutoff":0.8,"automatic":14,"toReview":0,"wrongAutomatic":0,"errorRateAmongAutomatic":0}
{"cutoff":0.95,"automatic":13,"toReview":1,"wrongAutomatic":0,"errorRateAmongAutomatic":0}
14 calls, gateway.cost total $0.00027728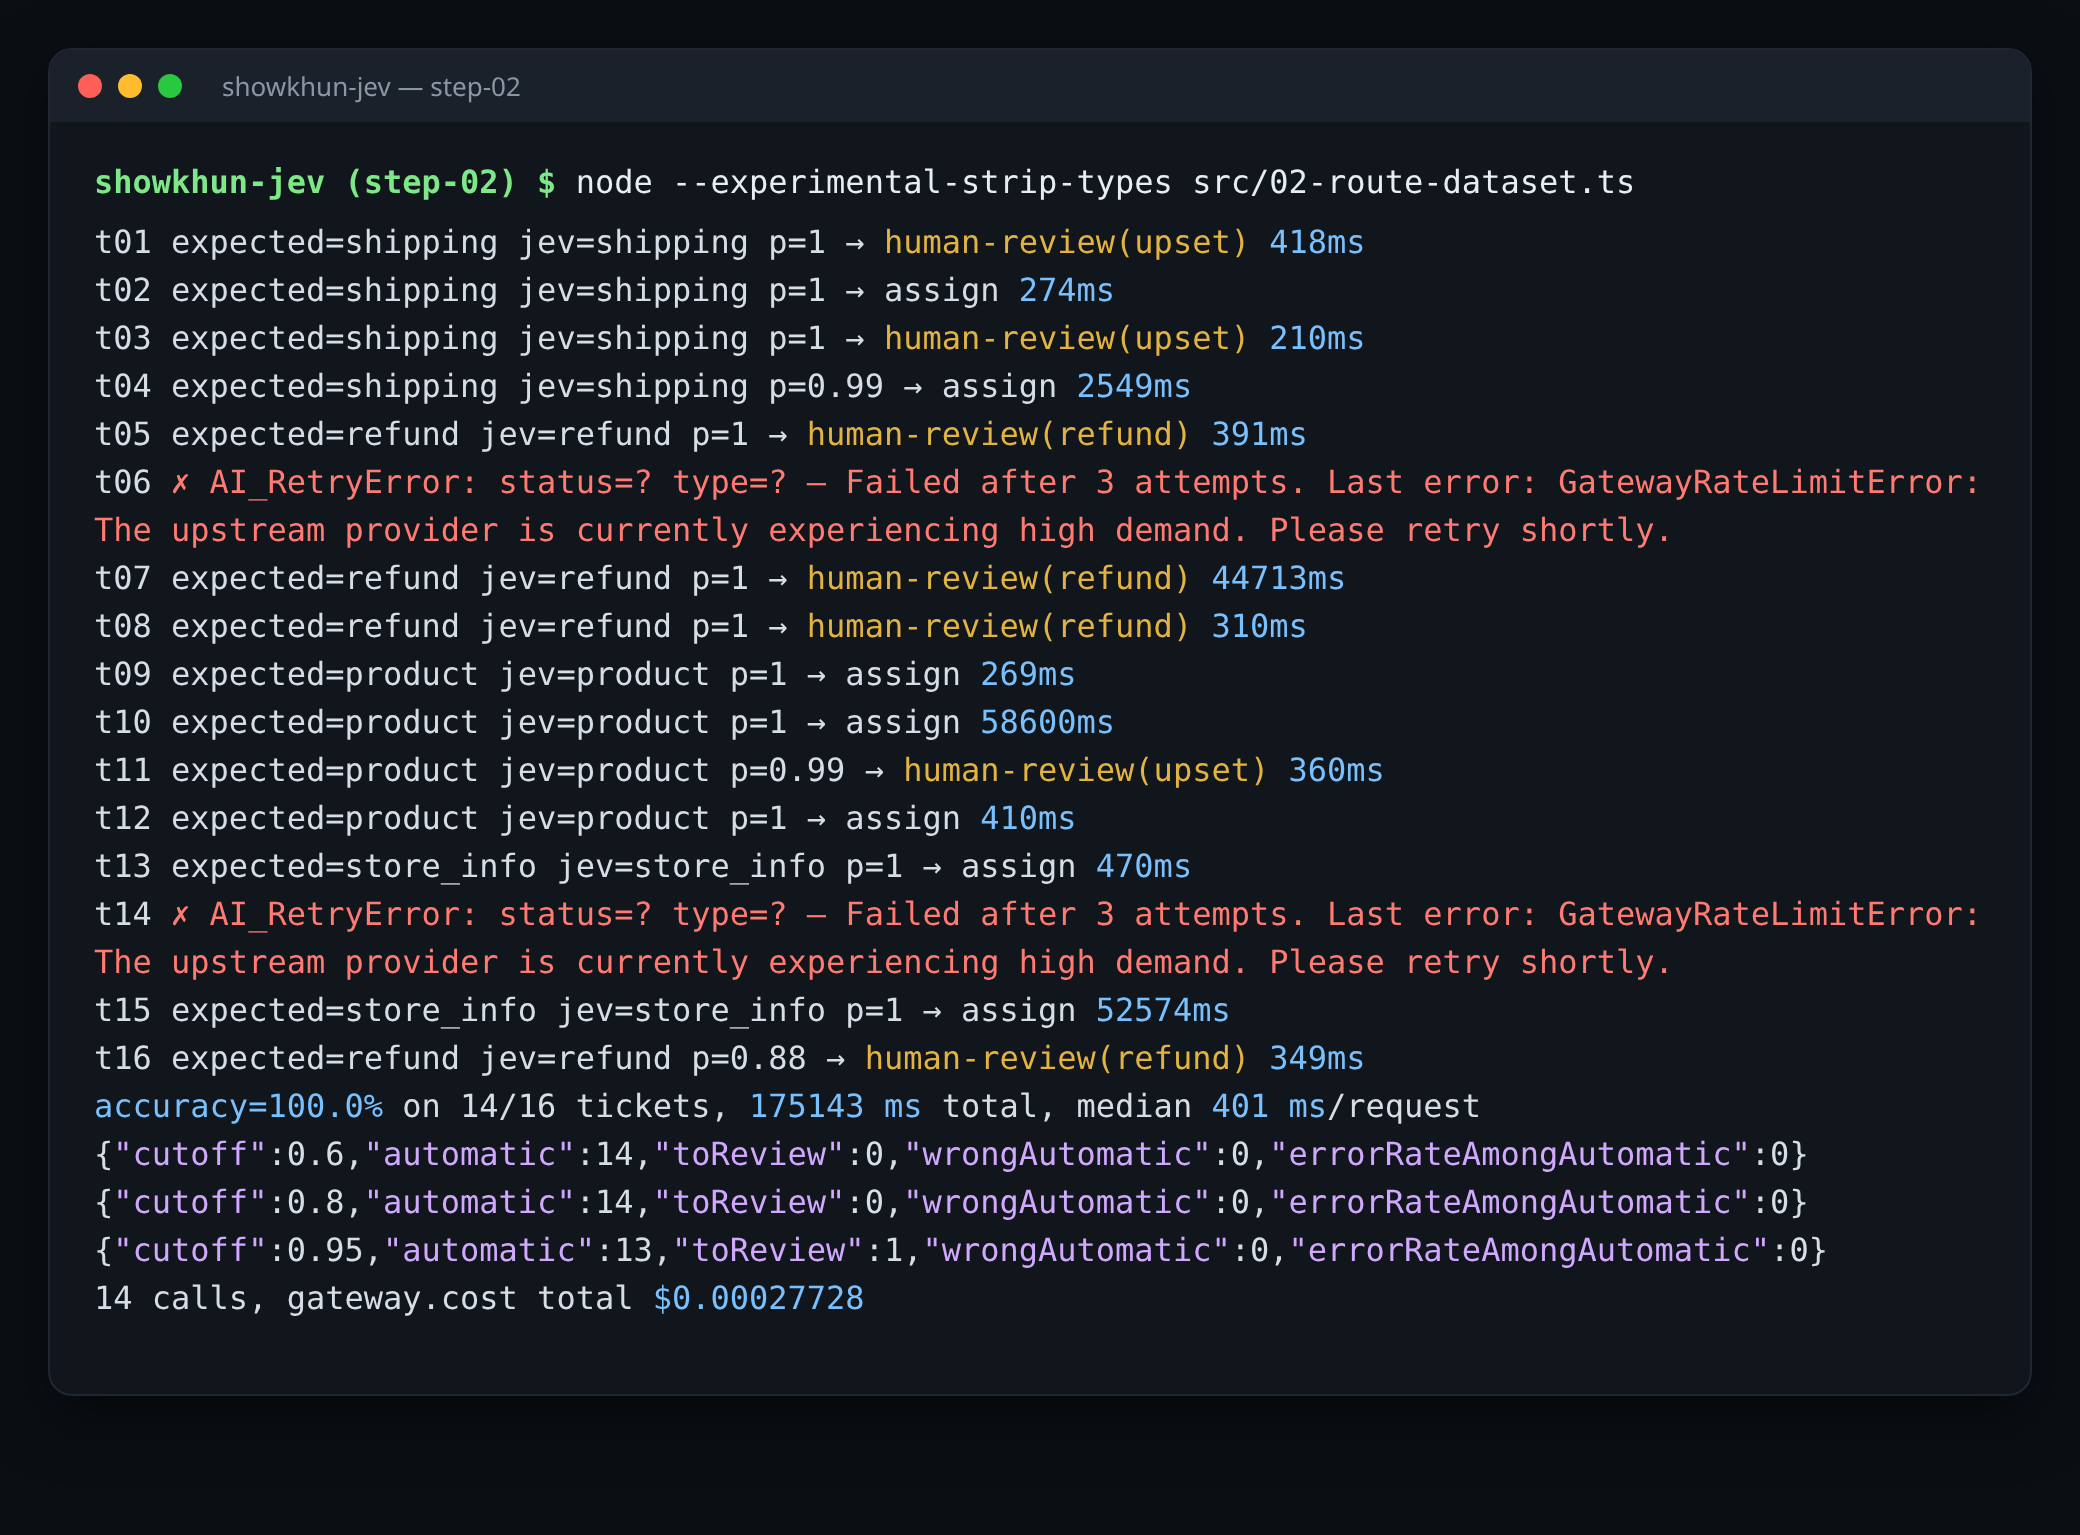
สิ่งที่เห็นจากรอบนี้ ตรงไปตรงมา:
- 14 ข้อที่ได้คำตอบ ถูกทั้ง 14 ข้อ ส่วน t06 กับ t14 ล้มเพราะ
GatewayRateLimitError: The upstream provider is currently experiencing high demandหลัง AI SDK retry ครบ 3 ครั้ง (ค่าเริ่มmaxRetries: 2) ผมรันสองข้อนั้นซ้ำทันทีด้วยคำถามชุดเดิม ได้t06 → refund p=1 → human-review(refund)และt14 → store_info p=1 → assignรวมเป็น ถูก 16/16 แต่ตัวเลขในกล่องด้านบนคือรอบแรกตามจริง - latency กลางๆ 401 ms แต่หางยาวมาก t07, t10, t15 ใช้ 44–59 วินาทีเพราะถูก rate limit แล้ว retry จนผ่าน เวลารวมเลยเป็น 175 วินาทีสำหรับ 16 ข้อความ งานจริงต้องตั้ง timeout และมีทางสำรอง (ส่งให้คน หรือ fallback ไป classifier อีกตัว) ไม่ใช่ปล่อยให้ลูกค้ารอเป็นนาที
- Jev มั่นใจสูงมากกับข้อมูลชุดนี้ 12 ใน 14 ข้อได้ p = 1 ข้อที่ต่ำสุดคือ t16 ข้อกำกวม (0.88) ตาราง cutoff จึงแทบไม่ต่างกัน: 0.6 กับ 0.8 ส่งอัตโนมัติ 14 ข้อ ผิด 0, 0.95 ส่ง t16 ไปให้คน 1 ข้อ แปลว่าข้อความทดสอบของเรา “ง่ายเกินไป” ที่จะเห็นผลของ threshold ชัดๆ ต้องใช้แชทจริงที่หลากหลายกว่านี้
- ข้อที่จบที่
human-reviewส่วนใหญ่ไม่ใช่เพราะ route ไม่มั่นใจ แต่เพราะกฎเรื่องเงิน (refund) และลูกค้าไม่พอใจ (upset) ซึ่งเป็นสิ่งที่เราต้องการ - ค่าใช้จ่ายรวม $0.00027728 สำหรับ 14 request (≈ $0.0000198 ต่อข้อความ) request ที่ล้มไม่มี response ให้อ่าน
gateway.costจึงไม่ถูกนับในตัวเลขนี้ ถ้าจะดูว่าถูกคิดเงินหรือไม่ ให้ดูใน Logs ของ dashboard
วิธีอ่านตาราง (อธิบายจากตัวอย่างสมมติในเอกสาร Vercel ไม่ใช่ผลเรา): ถ้าขยับเกณฑ์จาก 0.80 เป็น 0.95 ความผิดพลาดของงานอัตโนมัติลดลง แต่งานที่ต้องให้คนดูเพิ่มขึ้น จะเลือกแบบไหน ขึ้นกับว่าร้านมีแอดมินกี่คน และส่งผิดคิวแล้วเสียหายแค่ไหน ไม่มีตัวเลขวิเศษที่ใช้ได้ทุกร้าน
เทียบกับ LLM classifier ตัวเดิม
src/02-llm-baseline.ts คือ classifier จาก prototype (ใช้ generateText + Output.object กับ google/gemini-2.5-flash-lite ตาม รูปแบบในเอกสาร AI SDK กับ AI Gateway) รันกับ 16 ข้อความชุดเดียวกัน เพื่อเทียบสามเรื่อง: ความแม่น, เวลา, ค่าใช้จ่าย
ผลรันจริง (26 ก.ย. 2026 21:27 น.):
t01 expected=shipping llm=shipping needsHuman=true 903ms
t02 expected=shipping llm=shipping needsHuman=false 661ms
t03 expected=shipping llm=shipping needsHuman=true 780ms
t04 expected=shipping llm=shipping needsHuman=false 658ms
t05 expected=refund llm=refund needsHuman=true 622ms
t06 expected=refund llm=refund needsHuman=true 728ms
t07 expected=refund llm=refund needsHuman=true 730ms
t08 expected=refund llm=refund needsHuman=true 650ms
t09 expected=product llm=product needsHuman=true 740ms
t10 expected=product llm=product needsHuman=true 599ms
t11 expected=product llm=product needsHuman=true 680ms
t12 expected=product llm=product needsHuman=false 710ms
t13 expected=store_info llm=store_info needsHuman=false 679ms
t14 expected=store_info llm=store_info needsHuman=false 661ms
t15 expected=store_info llm=store_info needsHuman=true 577ms
t16 expected=refund llm=shipping needsHuman=true 676ms
accuracy=93.8% on 16 tickets, 11057 ms total, median 678 ms/request
16 calls, gateway.cost total $0.00016250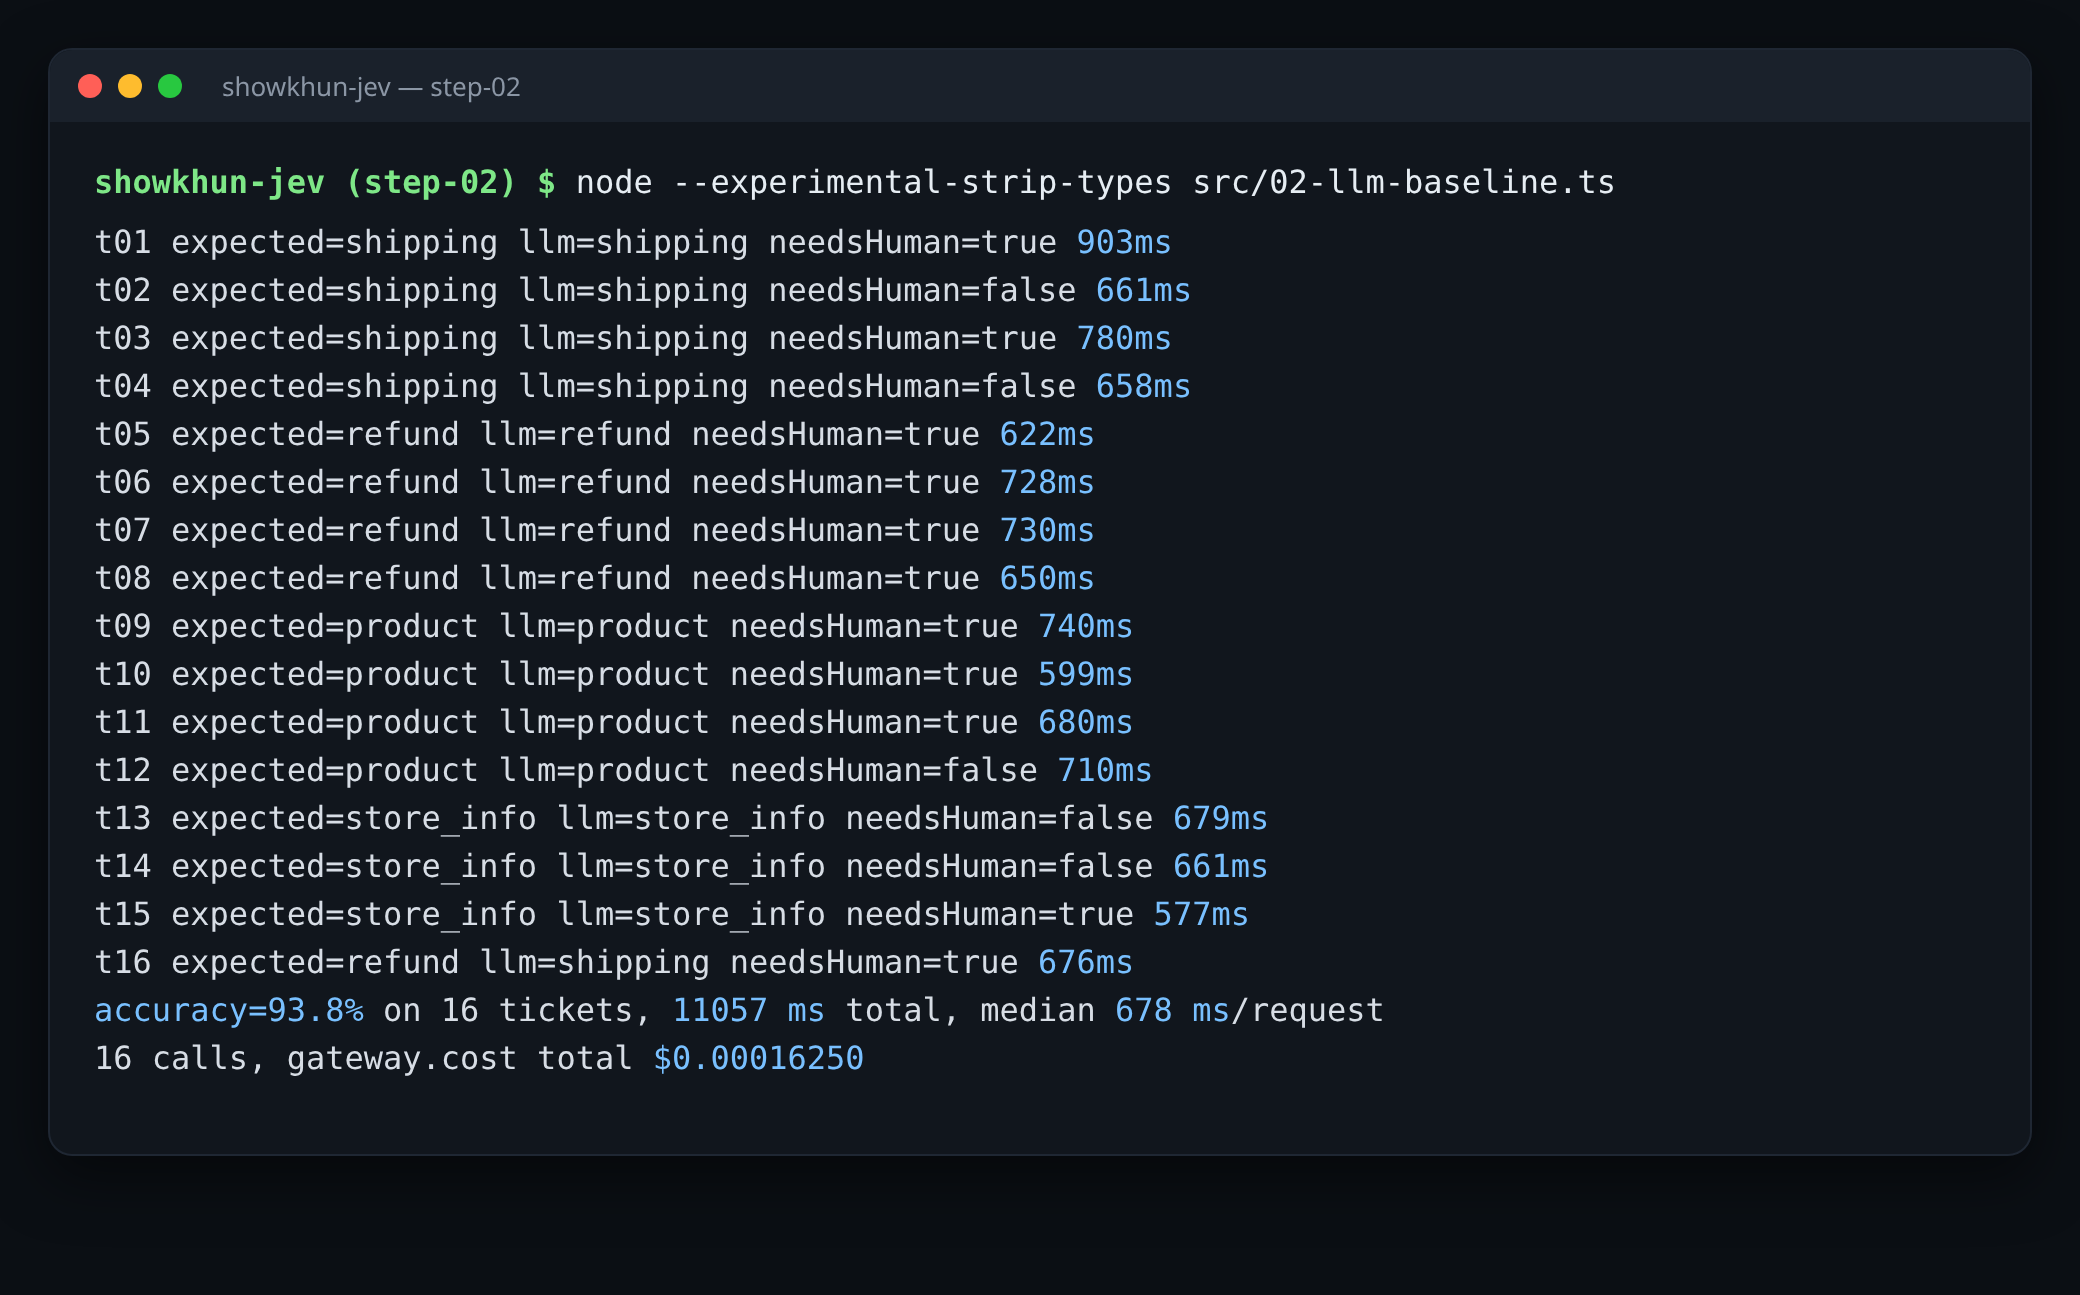
เทียบกันบน 16 ข้อความเดียวกัน:
Jev (typesafe-ai/jev) | LLM baseline (gemini-2.5-flash-lite) | |
|---|---|---|
| ถูก | 14/14 ในรอบแรก (16/16 รวมสองข้อที่รันซ้ำ) | 15/16 (93.8%) พลาด t16 ข้อกำกวม ตอบ shipping |
| median latency | 401 ms | 678 ms |
| เวลารวม | 175 วินาที (rate limit + retry) และล้ม 2 ข้อ | 11 วินาที ไม่มี error |
| ค่าใช้จ่ายต่อข้อความ | ≈ $0.0000198 | ≈ $0.0000102 |
| distribution สำหรับ threshold | มี | ไม่มี |
สรุปแบบไม่เชียร์ใคร: ในรอบนี้ Jev แม่นกว่าเล็กน้อยในข้อกำกวม และเร็วกว่าเมื่อไม่ติด rate limit แต่ แพงกว่าราว 2 เท่าต่อข้อความ และความเสถียรของ upstream ในวันที่ทดสอบแย่กว่ามาก ส่วน needsHuman ของ LLM ตอบ true ถึง 11 จาก 16 ข้อ รวมคำถามง่ายอย่าง “ไซซ์ M อกกี่นิ้วคะ” ถ้าใช้ค่านี้ตรงๆ แอดมินจะงานล้นเกินจำเป็น
ข้อควรระวังเวลาเทียบ: LLM ตัวนี้ไม่มี distribution ของตัวเลือก จึงใช้ threshold แบบเดียวกันไม่ได้ ตัวอย่างใน AI SDK ก็บอกว่า adapter ที่ใช้ LLM มาทำ evaluation จะไม่มี distribution ของ Choice/Score และความน่าจะเป็นแบบ Boolean ที่ได้ “ไม่รับประกันว่าคาลิเบรตแล้ว”
ข้อมูลที่ยังไม่ชัด
- ยังไม่มีเอกสารทางการยืนยันว่า Jev รองรับภาษาไทย ผลของเรา (16/16 ข้อความไทย รวมรอบรันซ้ำ) บอกว่าใช้กับภาษาไทยได้สมเหตุสมผล ผมลองเคสยากเพิ่มอีกนอกชุดนี้: ข้อความประชด “เยี่ยมมากเลยค่ะ รอของมาสองอาทิตย์แล้ว ยังไม่มาสักที 👏👏” ได้ upset 0.93 และ route shipping 1.0, ข้อความ “ไม่ได้อยากได้เงินคืนนะคะ แค่อยากเปลี่ยนเป็นไซซ์ L” ได้ wantsRefund 0.05 และ route product 0.99 ส่วนข้อความชมว่า “ได้รับของแล้วนะคะ สวยมาก ขอบคุณค่ะ” ถูกบังคับให้เลือกคิวเป็น product 0.76 เพราะเราไม่มีตัวเลือก “อื่นๆ” ใน criteria ร้านจริงควรเพิ่มตัวเลือกนั้น ทั้งหมดนี้ยังเป็นหลักฐานชิ้นเล็กมาก
- rate limit จากต้นทาง: วันที่ทดสอบ 2 ใน 16 request ล้มด้วย
GatewayRateLimitErrorและอีก 3 request ต้องรอ 44–59 วินาที ยังไม่รู้ว่าเป็นเพราะ Jev อยู่ในช่วง early access หรือเป็นแค่ช่วงเวลานั้น ควรมี timeout และ fallback ก่อนใช้กับแชทสด confidenceของ TypeSafe เป็นค่าเฉพาะของผู้ให้บริการ AI SDK ระบุ ว่าไม่ใช่ความน่าจะเป็นของตัวเลือกที่ถูกเลือก และไม่ใช่ตัวชี้วัดที่ใช้ข้ามโมเดลได้ workshop นี้จึงตัดสินใจจากprobabilitiesแทน (The Register ยกตัวอย่างที่ TypeSafe อธิบายไว้ว่าคำถามเลือกแผนกอาจได้ distribution เช่น technical 0.85 พร้อม confidence 0.82 แยกกันอีกค่า ซึ่งยืนยันว่าเป็นสองตัวเลขคนละความหมาย)
สรุปบทนี้
- threshold คือกติกา “มั่นใจพอก็ทำ ไม่มั่นใจก็ส่งคน” ตั้งต่อ action ไม่ใช่ตั้งค่าเดียวทั้งระบบ
- เรื่องเงินส่งคนเสมอ Jev จัดหมวดได้ แต่ไม่ใช่คนอนุมัติ
- distribution เป็น optional ห้ามแทนค่าที่หายไปด้วย 0 หรือ 1
- เทส threshold ด้วย mock model แบบ offline แล้ววัดความแม่นจริงด้วยข้อมูลที่ติดป้ายเอง รายงานตัวหารทุกครั้ง
บทหน้าเราจะเปลี่ยนบทบาท Jev จาก “คนคัดแยก” เป็น “คนตรวจการบ้าน” ให้มันตรวจคำตอบที่บอทร่างก่อนส่งถึงลูกค้า
Recap
-
pnpm testผ่านบน branchstep-02โดยไม่ใช้ key - รัน
02-route-dataset.tsแล้วได้ตาราง cutoff สามระดับ - เลือกเกณฑ์ที่เหมาะกับจำนวนแอดมินของร้านได้ และอธิบายเหตุผลได้
- โค้ดไม่แทนค่า distribution ที่หายไป
- เปรียบเทียบกับ LLM baseline ด้วยข้อมูลชุดเดียวกัน
Navigation
- ก่อนหน้า: Workshop #1: รู้จัก Jev โมเดลที่ไม่พูดสักคำ
- ถัดไป: Workshop #3: ให้ Jev ตรวจคำตอบของบอทก่อนส่งถึงลูกค้า
- โค้ดบทนี้: branch
step-02ในshowkhun-jev-workshop - ดูทั้งชุด: Jev Workshop