Jev Workshop #3: ให้ Jev ตรวจคำตอบของบอทก่อนส่งถึงลูกค้า
ตอนเด็กๆ ครูภาษาไทยไม่ได้เขียนเรียงความแทนเรา ครูแค่ถือปากกาแดง วงตรงที่ผิด แล้วบอกว่า “เขียนใหม่” บทนี้ Jev จะเป็นครูคนนั้นครับ LLM เป็นนักเรียนที่เขียนคล่องแต่ชอบมโน ส่วน Jev ไม่เขียนอะไรเลย (Vercel ย้ำว่า Jev ไม่สร้างข้อความ) แต่ตอบได้ว่า “ร่างนี้ส่งได้ไหม”
ไอเดียนี้ไม่ได้คิดเอง Vercel เขียนไว้เป็น use case ข้อ 7: คำตอบ support อาจฟังดูดีแต่ไม่ได้ตอบคำถามลูกค้า ให้ถาม Boolean ว่า “ตอบตรงประเด็นไหม” แล้วแยก Score ไว้ประเมินความชัดเจน
เป้าหมายของบทนี้
git checkout step-03
pnpm test                                               # 8 เทส ไม่ต้องใช้ key
node --experimental-strip-types src/03-check-drafts.ts  # ร่าง 3 ข้อความ + ตรวจ 3 ครั้ง
ตอนจบบทจะมี checkReply() ที่คืน { send: true } หรือ { send: false, reasons: [...] } ให้ระบบเลือกว่าจะส่งร่างถึงลูกค้า หรือพักไว้ให้แอดมินแก้
นโยบายร้านต้องอยู่ใน state
กับดักใหญ่ที่สุดของบทนี้: Jev รู้แค่สิ่งที่เราใส่ใน state ถ้าอยากให้มันจับได้ว่าบอท “สัญญาวันส่ง” เราต้องส่งนโยบายเรื่องวันส่งเข้าไปด้วย หน้า use cases เขียนไว้ชัดว่า “ข้อมูลอ้างอิงที่ใส่เข้าไปคือหลักฐานเดียวที่ใช้ตรวจได้” และถ้าต้องตรวจกับสถานะบัญชีจริง ต้องดึงข้อมูลจริงมาหรือเช็กในโค้ดเอง
ไฟล์ data/policy.ts จึงมีนโยบายสามข้อ (ข้อมูลสมมติของร้านตัวอย่าง): ส่ง 2–3 วันทำการแต่ไม่รับประกันวันถึง, คืนได้ใน 7 วันและต้องให้แอดมินอนุมัติทุกครั้ง, แอดมินตอบ 10:00–20:00
ร่างด้วย LLM ราคาถูก
ด้านล่างเป็นตัวอย่างโค้ดบางส่วนจาก src/draft.ts (fragment เพราะเรียกโมเดลผ่าน network) ใช้ instructions ซึ่งเป็นชื่อใหม่ของ system ใน AI SDK 7 ตาม ตารางเทียบเวอร์ชันของ Vercel
export async function draftReply(customer: string, model = CHEAP_LLM, tags: string[] = []) {
  return generateText({
    model,
    instructions: `คุณคือแอดมินร้านเสื้อผ้าออนไลน์ ตอบเป็นภาษาไทย สุภาพ ไม่เกิน 3 ประโยค ยึดนโยบายร้าน: ${JSON.stringify(SHOP_POLICY)}`,
    prompt: customer,
    maxOutputTokens: 160,
    providerOptions: { gateway: { tags } },
  });
}
ใส่นโยบายใน prompt แล้วก็จริง แต่ใส่แล้วไม่ได้แปลว่าบอทจะทำตามทุกครั้ง นั่นคือเหตุผลที่ต้องมีคนตรวจ
สามคำถามก่อนส่ง
ด้านล่างเป็นตัวอย่างโค้ดบางส่วนจาก src/reply-check.ts (ตัดชนิดข้อมูลและฟังก์ชันออก ไฟล์เต็มอยู่ใน step-03)
export const REPLY_QUESTIONS = {
  addressesConcern: {
    type: 'boolean',
    instructions: "Does the draft reply directly address the customer's actual question or problem?",
  },
  promisesBeyondPolicy: {
    type: 'boolean',
    instructions: 'Does the draft promise something the shop policy does not allow, such as an exact delivery date or an approved refund?',
    criteria: {
      true: 'promises a specific date, a guaranteed outcome, or a refund without admin approval',
      false: 'only states what the policy allows, or says an admin will check',
    },
  },
  tone: {
    type: 'score',
    instructions: 'How appropriate is the tone for a Thai online shop replying on LINE?',
    criteria: [
      'rude, dismissive or blaming the customer',
      'neutral but cold or robotic',
      'polite and friendly, uses ค่ะ/ครับ appropriately',
    ],
  },
};
// ...state: { policy: SHOP_POLICY, customer, draft }
ทำไมแยกเป็นสามข้อ: ตามหลัก “ถามแบบอะตอม” จาก KB guide คำตอบที่สุภาพมากแต่ไม่ตอบคำถาม กับคำตอบที่ตอบตรงแต่สัญญาเกิน เป็นปัญหาคนละแบบ ต้องแก้คนละวิธี ถ้ารวมเป็นข้อเดียวว่า “ร่างนี้ดีไหม” เราจะไม่รู้ว่าต้องแก้ตรงไหน
criteria ของ Boolean ใช้นิยามว่ากรณี true/false คืออะไร (Docs: Boolean) ผมเขียน “สัญญาวันส่ง” กับ “คืนเงินโดยไม่รออนุมัติ” ไว้ตรงๆ เพราะเป็นสองเรื่องที่ร้านเจ็บตัวจริง
ตรวจแล้วตัดสินยังไง
โค้ดนี้คือตรรกะเดียวกับ verdict() ใน repo แต่ย่อให้รันเดี่ยวได้ (verifier ของบล็อกรันจริงด้วย Bun) ค่าคำตอบในเคสเป็น ค่าสมมติ ไม่ใช่ผลจาก Jev
type ReplyAnswers = {
  addressesConcern: { probability: number };
  promisesBeyondPolicy: { probability: number };
  tone: { score: number }; // 0 = หยาบ, 1 = เย็นชา, 2 = สุภาพเป็นมิตร
};

const POLICY = { minAddresses: 0.7, maxPromise: 0.3, minTone: 1.5 };

function verdict(a: ReplyAnswers) {
  const reasons: string[] = [];
  if (a.addressesConcern.probability < POLICY.minAddresses) reasons.push('does-not-answer');
  if (a.promisesBeyondPolicy.probability > POLICY.maxPromise) reasons.push('over-promises');
  if (a.tone.score < POLICY.minTone) reasons.push('tone');
  return { send: reasons.length === 0, reasons };
}

const samples: Record<string, ReplyAnswers> = {
  'ตอบเวลาเปิดร้านถูกและสุภาพ': { addressesConcern: { probability: 0.93 }, promisesBeyondPolicy: { probability: 0.03 }, tone: { score: 1.9 } },
  '"พรุ่งนี้ถึงแน่นอนค่ะ"': { addressesConcern: { probability: 0.8 }, promisesBeyondPolicy: { probability: 0.91 }, tone: { score: 1.7 } },
  'ขายโปรแทนตอบไซซ์ + ห้วน': { addressesConcern: { probability: 0.12 }, promisesBeyondPolicy: { probability: 0.05 }, tone: { score: 0.9 } },
};
for (const [name, a] of Object.entries(samples)) console.log(name, '→', JSON.stringify(verdict(a)));
เกณฑ์ 0.7 / 0.3 / 1.5 เป็นค่าเริ่มต้นที่ผมตั้งไว้ให้เริ่มทดลอง ยังไม่ได้วัด บทหน้าเราจะวัดมันกับคำตอบที่คนตัดสินไว้แล้ว ซึ่งตรงกับ คำแนะนำของ Vercel ให้เริ่มจากคำตอบที่คนรีวิวแล้ว แล้วดูจุดที่ Jev เห็นต่าง ก่อนใช้ตรวจแชทสด
รันดู
src/03-check-drafts.ts หยิบข้อความลูกค้าสามข้อ (พัสดุช้า, สินค้ามีตำหนิขอคืนเงิน, ขู่ยกเลิกถ้าของไม่มา) ให้ gemini-2.5-flash-lite ร่างคำตอบ แล้วให้ Jev ตรวจ
ผลรันจริงเมื่อ 26 ก.ย. 2026 เวลา 21:27 น. (เวลาไทย) ร่างทั้งสามข้อเป็นข้อความที่ LLM เขียนจริง ไม่ได้แก้:
[t01] ลูกค้า: สั่งเสื้อไปตั้งแต่วันจันทร์ ยังไม่ได้ของเลยค่ะ เลขออเดอร์ #A1029
ร่าง: สวัสดีค่ะ ขอบคุณที่อุดหนุนนะคะ สำหรับออเดอร์ #A1029 ทางร้านจะจัดส่งให้ภายใน 2-3 วันทำการหลังชำระเงินค่ะ หากยังไม่ได้รับสินค้าภายในระยะเวลาดังกล่าว สามารถแจ้งแอดมินได้เลยค่ะ
jev: {"addressesConcern":{"type":"boolean","probability":0.69},"promisesBeyondPolicy":{"type":"boolean","probability":0.1},"tone":{"type":"score","score":1.99,"probabilities":{"0":0,"1":0,"2":1}}} confidence={"tone":0.99}
→ HOLD (does-not-answer)
draft 920ms $0.0000381 | check 267ms $0.000038136 (908 input tokens)

[t05] ลูกค้า: สินค้ามีตำหนิ ขอคืนเงินได้ไหมครับ ผิดหวังมาก
ร่าง: สวัสดีค่ะ หากสินค้ามีตำหนิ ทางร้านยินดีรับคืนค่ะ รบกวนคุณลูกค้าแจ้งรายละเอียดตำหนิและทำการคืนสินค้าภายใน 7 วันหลังได้รับสินค้า โดยสินค้าต้องไม่ผ่านการซักและขอให้แอดมินอนุมัติการคืนเงินก่อนนะคะ
jev: {"addressesConcern":{"type":"boolean","probability":0.93},"promisesBeyondPolicy":{"type":"boolean","probability":0.11},"tone":{"type":"score","score":1.99,"probabilities":{"0":0,"1":0.01,"2":0.99}}} confidence={"tone":0.99}
→ SEND
draft 805ms $0.000038 | check 453ms $0.00003822 (910 input tokens)

[t16] ลูกค้า: ถ้าพรุ่งนี้ของยังไม่มา ขอยกเลิกและคืนเงินนะ
ร่าง: สวัสดีค่ะ หากสินค้ายังไม่ถึงภายในวันพรุ่งนี้ สามารถแจ้งความประสงค์เพื่อดำเนินการยกเลิกและคืนเงินได้เลยค่ะ โดยสินค้าที่จะทำการคืนต้องอยู่ในสภาพสมบูรณ์ ไม่ผ่านการซัก และต้องได้รับการอนุมัติจากแอดมินก่อนนะคะ
jev: {"addressesConcern":{"type":"boolean","probability":0.85},"promisesBeyondPolicy":{"type":"boolean","probability":0.17},"tone":{"type":"score","score":2,"probabilities":{"0":0,"1":0,"2":1}}} confidence={"tone":0.99}
→ SEND
draft 767ms $0.0000369 | check 282ms $0.000038682 (921 input tokens)

6 calls, gateway.cost total $0.00022804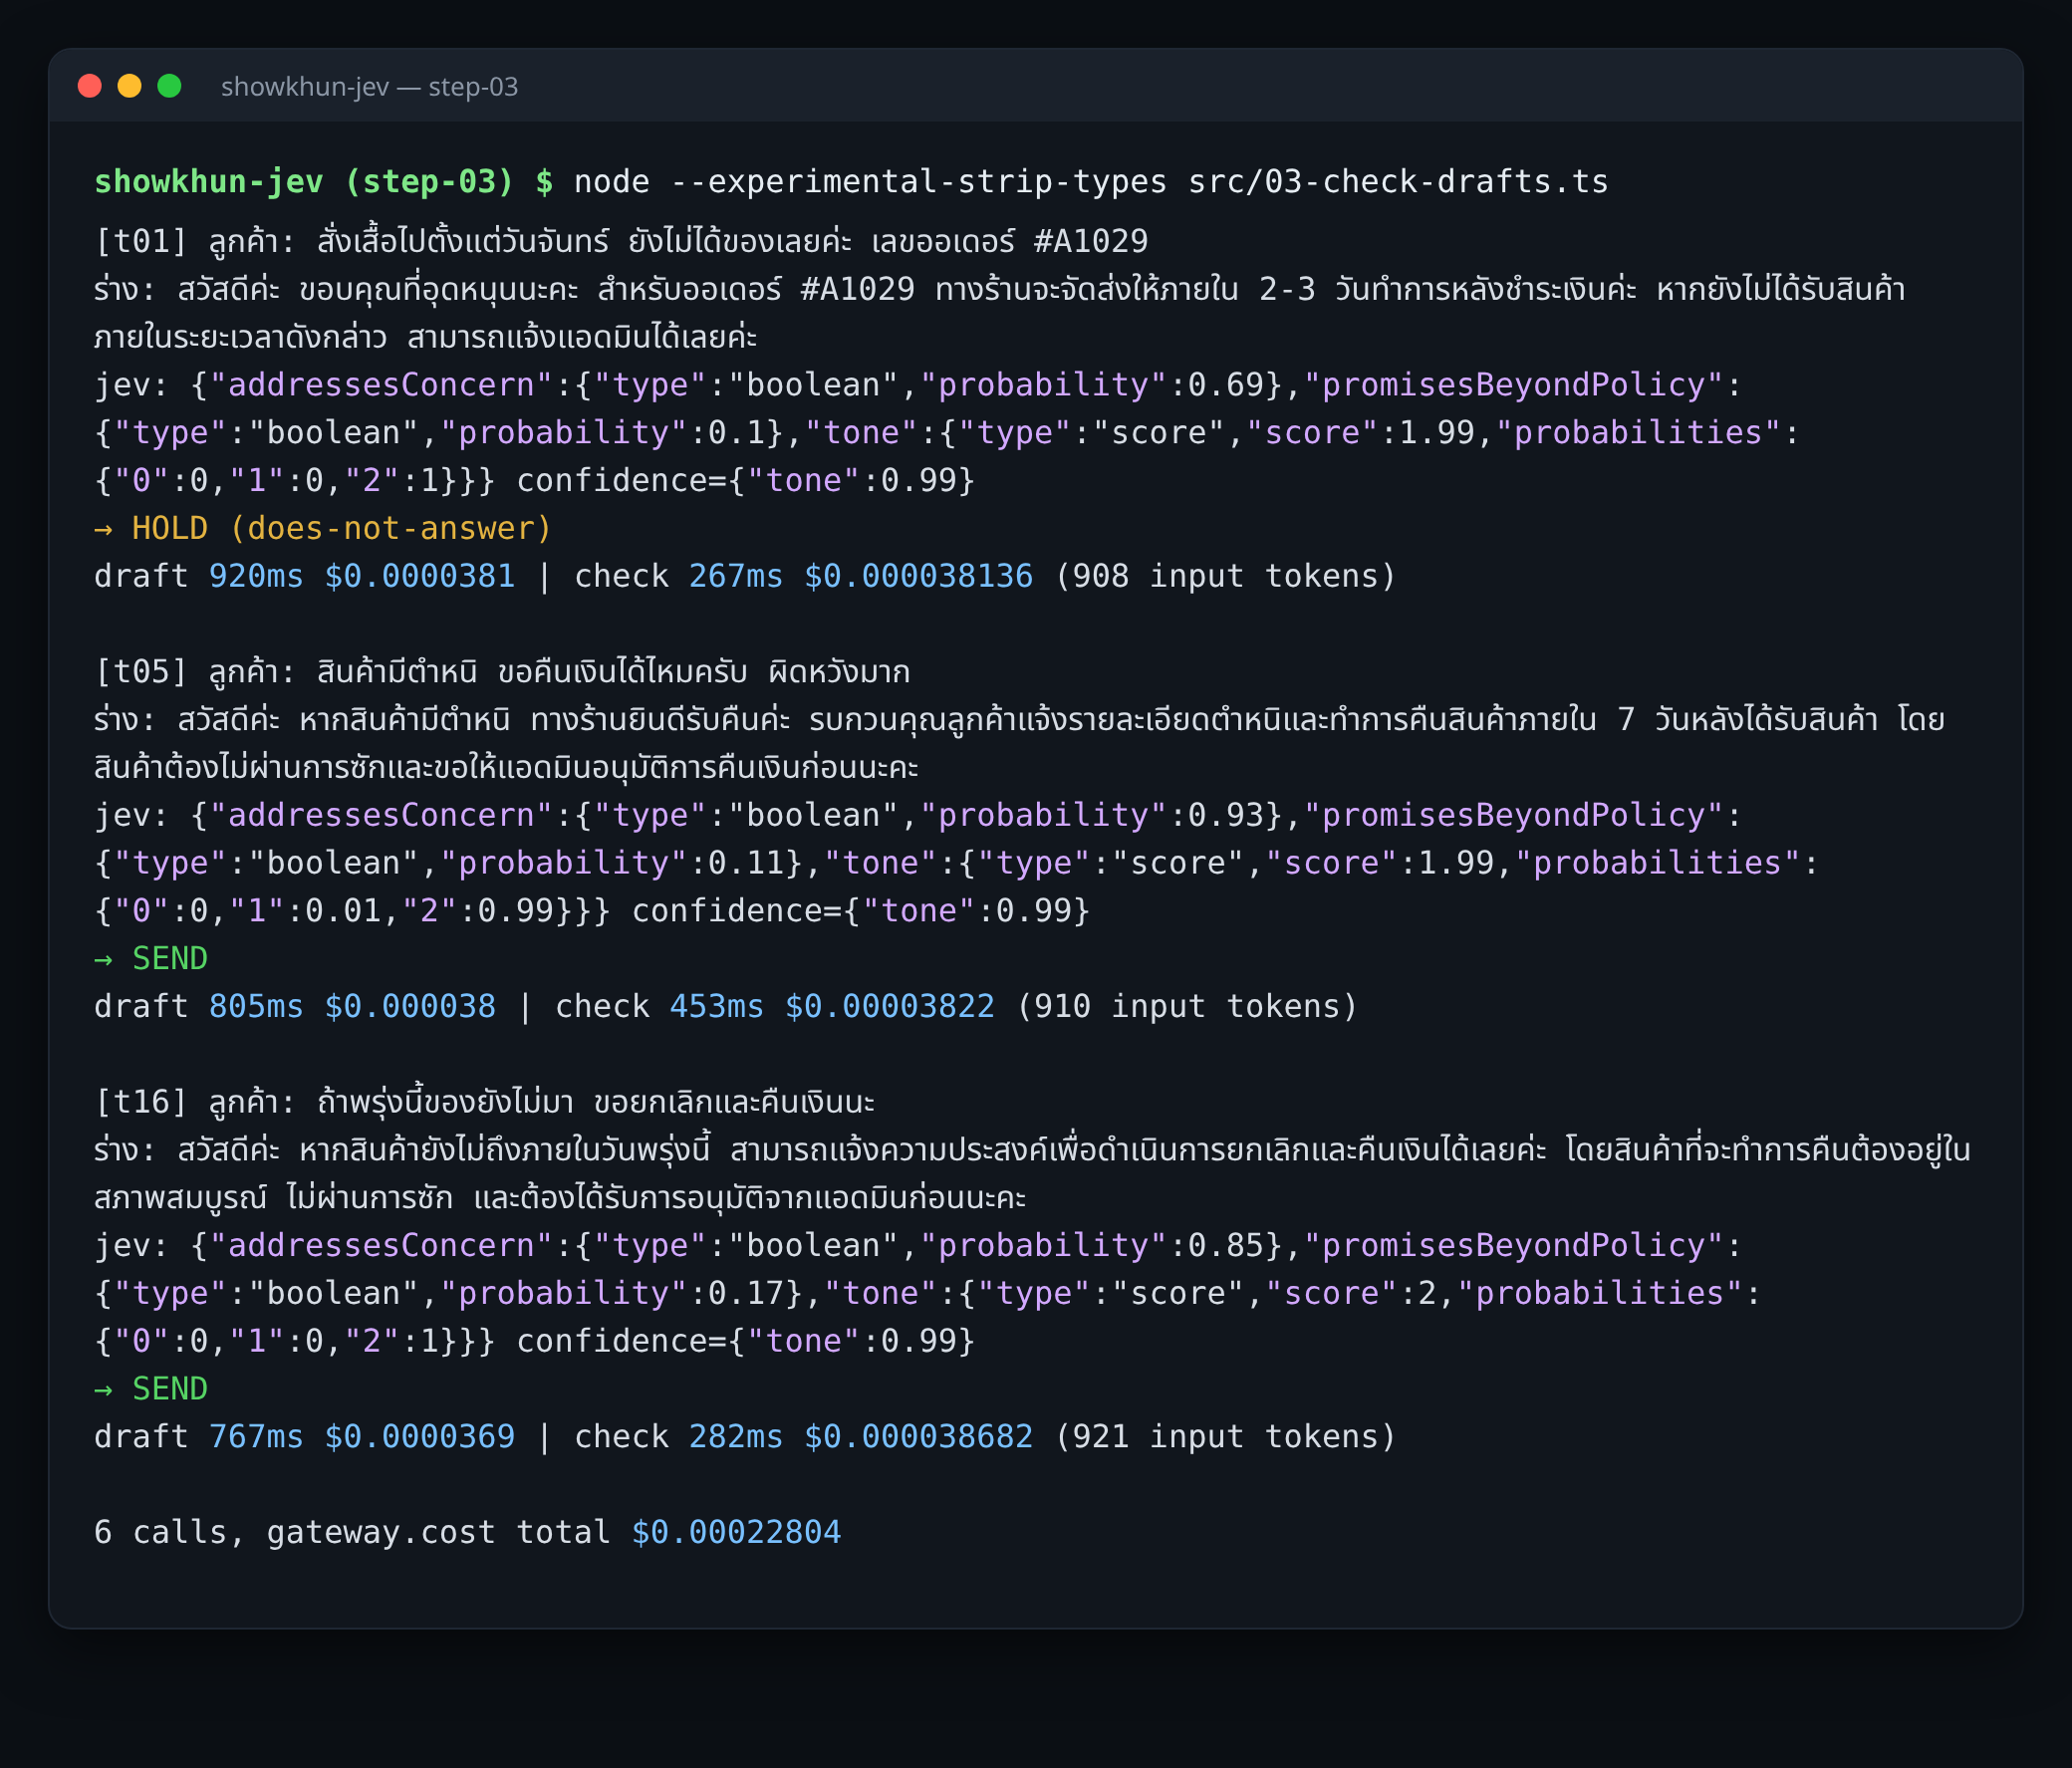
อ่านผลทีละข้อ:
- t01 (พัสดุช้า) → HOLD ร่างนี้สุภาพ (tone 1.99) และไม่สัญญาเกิน (0.1) แต่ไม่ได้ตอบสิ่งที่ลูกค้าอยากรู้จริงๆ คือ “ของฉันอยู่ไหน” แค่ทวนนโยบายว่าส่ง 2–3 วันทำการ Jev ให้
addressesConcern0.69 ต่ำกว่าเกณฑ์ 0.7 แค่นิดเดียว ผมว่าการพักข้อนี้สมเหตุสมผล แต่ก็เห็นชัดว่าเกณฑ์กำลังตัดสินที่ขอบพอดี ถ้าเกณฑ์เป็น 0.65 ข้อนี้จะหลุดไปถึงลูกค้า - t05 (สินค้ามีตำหนิ ขอคืนเงิน) → SEND ร่างบอกเงื่อนไข 7 วัน ไม่ผ่านการซัก และต้องรอแอดมินอนุมัติ ตรงนโยบาย Jev ให้
promisesBeyondPolicy0.11 - t16 (ขู่ยกเลิกถ้าของไม่มา) → SEND ร่างไม่ได้สัญญาว่าของจะถึงพรุ่งนี้ และบอกว่าการคืนเงินต้องรอแอดมินอนุมัติ Jev ให้ 0.17 ข้อสังเกต: ร่างนี้พูดถึง “สภาพสมบูรณ์ ไม่ผ่านการซัก” ทั้งที่ลูกค้ายังไม่ได้รับของ ซึ่งแปลกๆ แต่ไม่ผิดนโยบาย คำถามสามข้อของเราไม่ได้ถามเรื่องนี้ Jev จึงไม่จับ
- ค่าใช้จ่ายและเวลา: การตรวจแต่ละครั้งใช้ราว 910 input token (นโยบายร้าน + ลูกค้า + ร่าง + คำถามสามข้อ) ≈ $0.000038 พอๆ กับค่าร่างเองเลย ($0.000037–0.000038) แปลว่าเพิ่มด่านตรวจแล้วค่าใช้จ่ายต่อแชทราวสองเท่า ส่วนเวลา การตรวจใช้ 267–453 ms ร่างใช้ 767–920 ms รวมทั้งหมด 6 request $0.00022804
ถ้าร่างถูกพัก (HOLD) ระบบจริงทำได้สองแบบ: ส่งให้แอดมินแก้ หรือให้ LLM ร่างใหม่โดยแนบเหตุผล (over-promises) กลับไปใน prompt แล้วตรวจอีกรอบ แบบหลังต้องมีเพดานจำนวนรอบ ไม่งั้นบอทกับครูอาจเถียงกันจนเช้า
ข้อควรระวัง
- Jev ไม่รู้ข้อเท็จจริงนอก state ถ้าบอทเขียนว่า “เลขพัสดุคือ TH123” Jev ไม่รู้ว่าเลขนี้ถูกไหม ต้องเช็กกับระบบขนส่งในโค้ดเอง Vercel แนะนำ ให้ใช้ deterministic check กับเงื่อนไขที่ตรวจแบบแม่นยำได้
- คำตอบมีโครงสร้าง ≠ คำตอบถูก อย่างที่ The Register ตั้งข้อสังเกต ว่าการตอบเป็นโครงสร้างพร้อมความน่าจะเป็น “ไม่ได้กันความผิดพลาด” ครูก็วงผิดได้เหมือนกัน
- ภาษาไทยปนอังกฤษ คำถามเราเขียนเป็นอังกฤษ แต่ state เป็นไทย ยังไม่มีเอกสารบอกว่าแบบไหนดีกว่า ผมลองเขียนคำถามชุดคัดแยกเป็นภาษาไทยทั้งหมด แล้วถามกับสองข้อความ ผลแทบเหมือนเดิม (ข้อความโกรธขอคืนเงิน: route refund 0.99, wantsRefund 0.98, upset 0.98 เทียบกับฉบับอังกฤษ 1.0 / 0.96 / 0.99) แต่ ใช้ input token มากขึ้นราว 52–58% (852 เทียบ 562 และ 793 เทียบ 503) เพราะภาษาไทยกิน token มากกว่า workshop นี้จึงเขียนคำถามเป็นอังกฤษ ทดสอบแค่ 2 ข้อความ ยังสรุปเรื่องความแม่นไม่ได้ แต่เรื่อง token ชัดเจน
สรุปบทนี้
- LLM ร่าง, Jev ตรวจ แบ่งงานตามจุดแข็ง: Jev ไม่เขียนข้อความ แต่ตอบว่า “ส่งได้ไหม” ได้
- นโยบายร้านต้องอยู่ใน state ไม่งั้น Jev ไม่มีหลักฐานให้ตรวจ
- แยกคำถาม: ตอบตรงไหม / สัญญาเกินไหม / น้ำเสียงเป็นยังไง เพื่อรู้ว่าต้องแก้ตรงไหน
- เกณฑ์ที่ตั้งตอนนี้เป็นค่าเริ่มต้น ต้องวัดกับคำตอบที่คนตัดสินไว้ก่อนใช้จริง
บทสุดท้ายเราจะเปลี่ยนการตรวจนี้เป็น ด่านใน CI ใครแก้ prompt แล้วคุณภาพตก PR จะไม่ผ่าน พร้อมเทียบโมเดลร่างถูก-แพงว่าคุ้มต่อบาทแค่ไหน
Recap
-
pnpm testผ่าน 8 เทสบนstep-03 - นโยบายร้านถูกส่งใน
stateทุกครั้งที่ตรวจ - รัน
03-check-drafts.tsได้ผล SEND/HOLD พร้อมเหตุผล - อธิบายได้ว่าทำไมไม่ถามข้อเดียวว่า “ร่างนี้ดีไหม”
- มีเพดานจำนวนรอบถ้าให้ LLM ร่างใหม่อัตโนมัติ
Navigation
- ก่อนหน้า: Workshop #2: คัดแยกแชทลูกค้าด้วยความน่าจะเป็น
- ถัดไป: Workshop #4: ด่านตรวจใน CI และเทียบโมเดลแบบคุ้มต่อบาท
- โค้ดบทนี้: branch
step-03ในshowkhun-jev-workshop - ดูทั้งชุด: Jev Workshop