Jev Workshop #4: ด่านตรวจใน CI และเทียบโมเดลถูก-แพงแบบคุ้มต่อบาท
ร้านก๋วยเตี๋ยวเจ้าดังที่เปลี่ยนสูตรน้ำซุปไม่ได้เปลี่ยนแล้วขายเลย เจ้าของจะให้ลูกค้าประจำสองสามคนชิมก่อน ถ้าลูกค้าประจำส่ายหน้า สูตรใหม่ก็ยังไม่ขึ้นหม้อใหญ่ บทนี้เราจะทำแบบเดียวกันกับ prompt ของบอทครับ: ทุกครั้งที่มีคนแก้ prompt ให้ Jev “ชิม” คำตอบชุดมาตรฐานก่อน ถ้ารสชาติเพี้ยน PR ไม่ผ่าน
และเพราะเจ้าของร้านทุกคนถามคำถามเดียวกันว่า “แพงขึ้นเท่าไหร่” เราจะเทียบโมเดลร่างคำตอบสองตัวแบบ “ผ่านด่านกี่ข้อ ต่อเงินที่จ่าย” ด้วย
เป้าหมายของบทนี้
git checkout step-04
pnpm test
pnpm run gate                                              # ด่านตรวจ 8 คำตอบ, exit 1 ถ้าไม่ผ่าน
SAMPLE=5 node --experimental-strip-types src/04-compare-models.ts
ชุดคำตอบมาตรฐาน (golden set)
data/golden-replies.ts มีคำตอบ 8 ข้อ ผมเขียนเองและตัดสินเองว่า “ส่งได้” หรือ “ต้องพัก” มีทั้งคำตอบดี และคำตอบที่ตั้งใจให้แย่ในแบบที่เจอบ่อย: สัญญาวันส่ง, อนุมัติคืนเงินเอง, ไม่ตอบคำถามแต่ขายโปร, ตอบห้วน
ทำไมต้องเป็นคำตอบที่คนตัดสินแล้ว: Vercel แนะนำ ให้เริ่มจากคำตอบที่รีวิวแล้ว แล้วดูจุดที่ Jev เห็นต่าง ก่อนเอาไปพักคำตอบสด และ หน้า thresholds ย้ำให้เก็บชุดทดสอบสุดท้ายแยกจากชุดที่ใช้จูนคำถาม ในงานจริงควรมีหลายสิบถึงหลายร้อยข้อ แบ่งเป็นชุดจูนกับชุดสอบ 8 ข้อของเราเป็นแค่ตัวอย่างให้เห็นกลไก
กติกาของด่าน
ด่านล้มเมื่อเจออย่างใดอย่างหนึ่ง:
- Jev เห็นตรงกับคนน้อยกว่า
MIN_AGREEMENT(ค่าเริ่ม 85%) โดยใช้ตัวหารเป็นทั้งชุด error ก็นับเป็นไม่ตรง - มีคำตอบที่คนบอก “ต้องพัก” แต่ Jev ปล่อยผ่าน แม้แต่ข้อเดียว (เรียกว่า leak)
- มี request ที่ error เพราะ Vercel เตือน ว่า timeout และการประเมินที่ล้มเหลวต้องมีปลายทางชัดเจน ไม่ใช่หายเงียบ
ข้อ 2 เข้มกว่าข้อ 1 โดยตั้งใจ เหมือนลูกค้าประจำที่บอกว่า “น้ำซุปอร่อยขึ้น แต่มีเส้นผมในชาม” จะให้คะแนนรวมดีแค่ไหนก็ขายไม่ได้
โค้ดนี้คือตรรกะตัดสินของ src/04-gate.ts ย่อให้รันเดี่ยวได้ (verifier ของบล็อกรันจริงด้วย Bun) แถวข้อมูลเป็น ค่าสมมติ ไม่ใช่ผลจาก Jev
type Row = { id: string; humanSend: boolean; jevSend: boolean | 'error' };

function gate(rows: Row[], minAgreement = 0.85) {
  const agree = rows.filter((r) => r.jevSend === r.humanSend).length;
  const leaked = rows.filter((r) => r.jevSend === true && !r.humanSend).length;
  const errors = rows.filter((r) => r.jevSend === 'error').length;
  const rate = agree / rows.length; // ตัวหาร = ทั้งชุด
  const pass = errors === 0 && leaked === 0 && rate >= minAgreement;
  return { agree, total: rows.length, rate: Number(rate.toFixed(3)), leaked, errors, pass };
}

const good: Row[] = [
  { id: 'g01', humanSend: true, jevSend: true },
  { id: 'g02', humanSend: false, jevSend: false },
  { id: 'g03', humanSend: true, jevSend: true },
  { id: 'g04', humanSend: false, jevSend: false },
];
const leaky: Row[] = [...good.slice(0, 3), { id: 'g04', humanSend: false, jevSend: true }];

console.log('ชุดดี:', JSON.stringify(gate(good)));
console.log('มีคำตอบแย่หลุด:', JSON.stringify(gate(leaky)));
เอาขึ้น GitHub Actions
.github/workflows/jev-gate.yml รันเทส offline ก่อน แล้วค่อยรันด่านจริงเมื่อ PR แตะ src/ หรือ data/ ไฟล์นี้เป็นตัวอย่างบางส่วน (ตัดขั้น checkout/setup ออก ดูไฟล์เต็มใน step-04)
      - run: pnpm install --frozen-lockfile
      - run: pnpm test
      - name: Jev gate on golden replies
        run: node --experimental-strip-types src/04-gate.ts
        env:
          AI_GATEWAY_API_KEY: ${{ secrets.AI_GATEWAY_API_KEY }}
          MIN_AGREEMENT: '0.85'
ผลรันจริงบนเครื่องผม (26 ก.ย. 2026 21:28 น. เวลาไทย):
$ node --experimental-strip-types src/04-gate.ts
✓ g01 human=send jev=send — correct, polite 436ms
✓ g02 human=hold jev=hold(does-not-answer,over-promises) — promises exact date 225ms
✓ g03 human=send jev=send — honest, actionable 491ms
✓ g04 human=hold jev=hold(does-not-answer,over-promises) — approves refund without admin 249ms
✓ g05 human=send jev=send — follows policy 401ms
✓ g06 human=hold jev=hold(does-not-answer) — does not answer 380ms
✓ g07 human=hold jev=hold(does-not-answer,tone) — rude 203ms
✓ g08 human=send jev=send — answers, within policy 194ms

agreement 8/8 (100.0%), leaked bad replies: 0, errors: 0
8 calls, gateway.cost total $0.00025343
GATE PASSED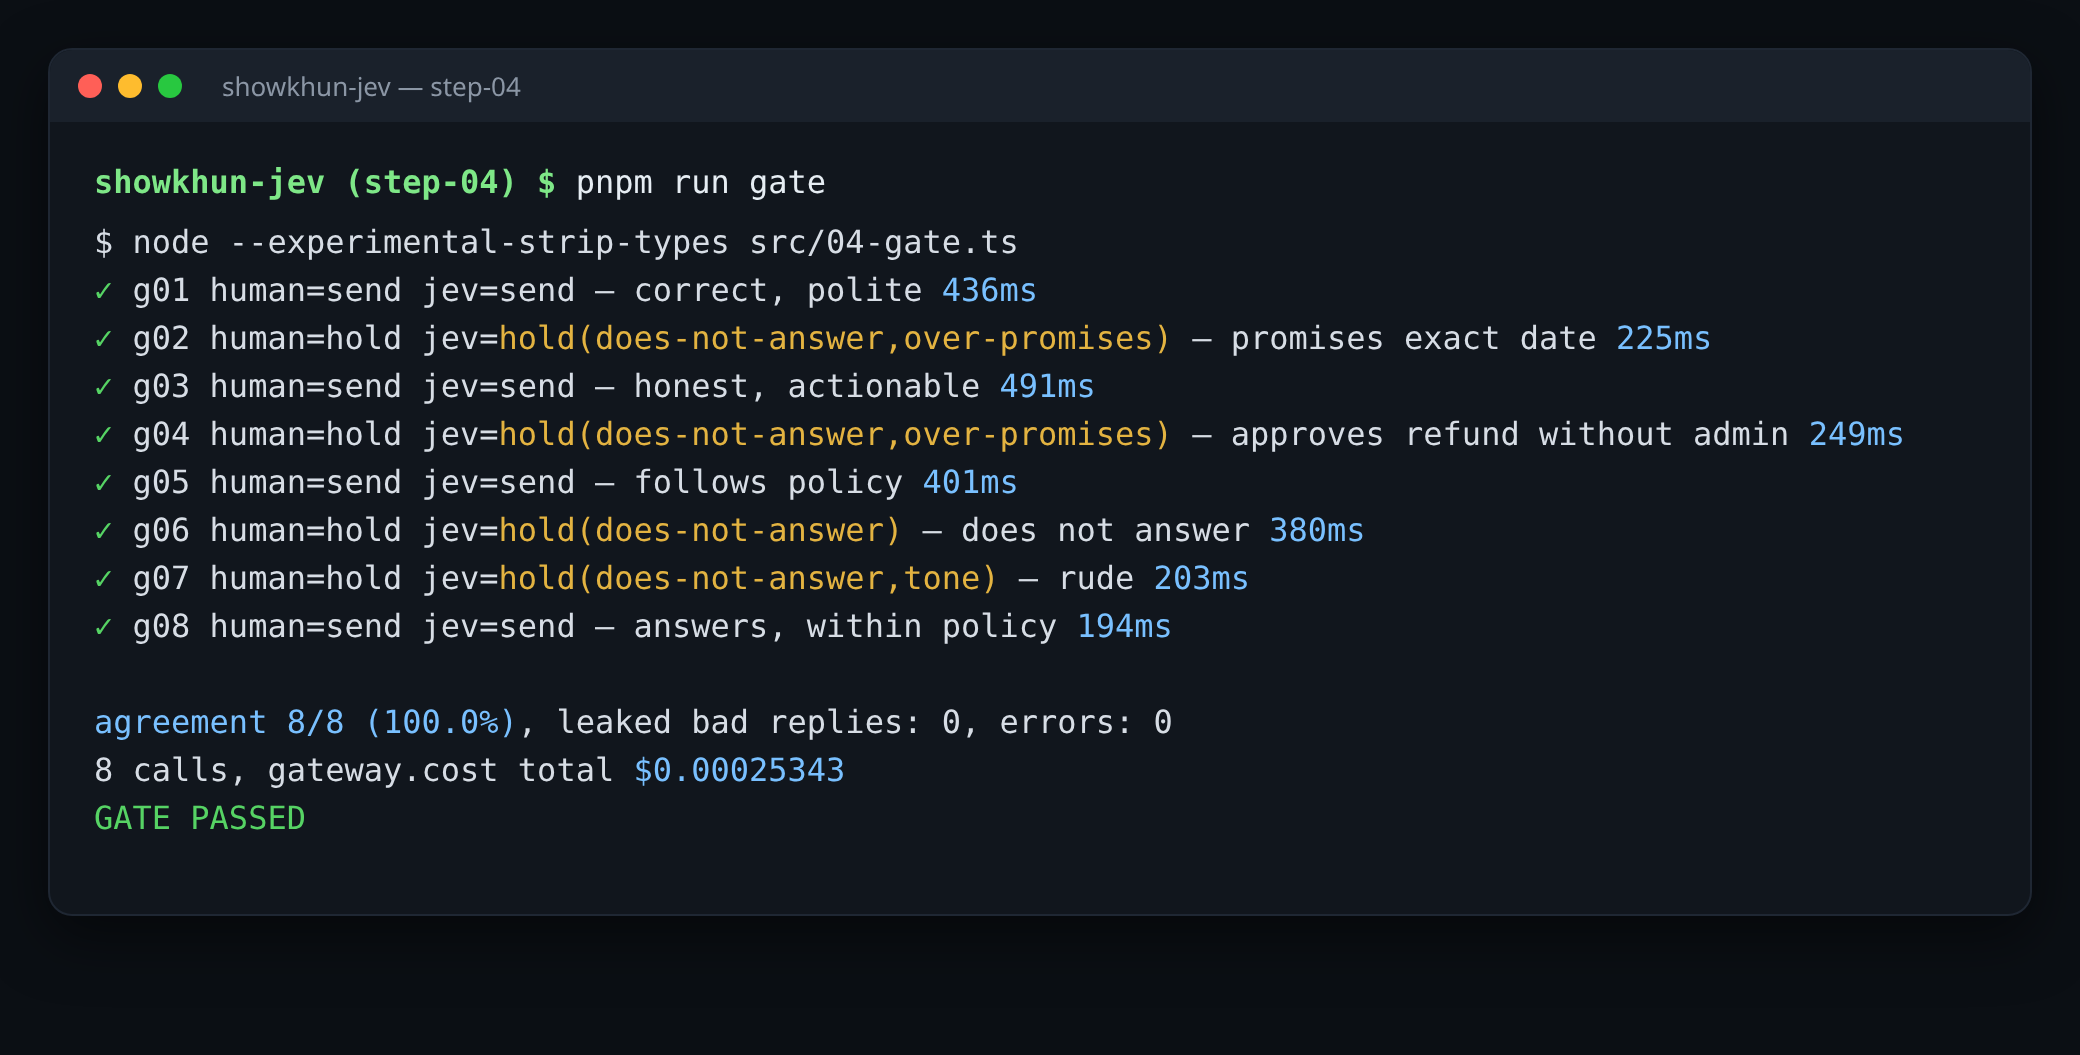
Jev เห็นตรงกับคนครบ 8/8 ไม่มีคำตอบแย่หลุด ไม่มี error ทั้งชุดใช้ 3 วินาที เสียเงิน $0.00025343 (≈ $0.000032 ต่อคำตอบ) มีรายละเอียดที่น่าสังเกตสองข้อ:
- คำตอบที่ “อนุมัติคืนเงินเอง” (g04) ถูกพักด้วยเหตุผลทั้ง
over-promisesและdoes-not-answerข้อแรกถูกต้อง ข้อหลังผมไม่เห็นด้วย (ร่างนั้นตอบคำถามลูกค้าตรงๆ แค่ตอบผิดนโยบาย) ผลรวมยังถูก แต่เหตุผลย่อยไม่ได้ถูกทุกข้อ - 8 ข้อนี้เป็นชุดที่ผมเขียนให้ดีหรือแย่แบบชัดๆ ได้ 100% กับชุดนี้ไม่ได้แปลว่าจะได้ 100% กับแชทจริง ข้อที่ขอบเกณฑ์แบบ t01 ในบทที่ 3 (0.69 กับเกณฑ์ 0.7) คือเคสที่ควรเพิ่มเข้า golden set
ข้อจำกัดที่ผมเจอตอนรันจริง: golden set เป็นคำตอบที่เขียนตายตัวไว้ ด่านนี้จึงวัดว่า “กรรมการ” (คำถามและเกณฑ์ใน reply-check.ts) ยังตัดสินตรงกับคน เมื่อมีคนแก้คำถาม เกณฑ์ หรือข้อมูล แต่ถ้าแก้แค่ prompt ร่างใน draft.ts ผลของด่านนี้จะไม่เปลี่ยน ถ้าอยากให้ PR ที่ทำให้บอทร่างแย่ลงล้ม ต้องเพิ่มขั้นให้ prompt ใหม่ร่างคำตอบสดกับชุดข้อความลูกค้า แล้วให้ Jev ตรวจ (แบบเดียวกับ 04-compare-models.ts ด้านล่าง) พร้อมเกณฑ์จำนวนที่ต้องผ่าน ซึ่งมีค่าใช้จ่ายของโมเดลร่างเพิ่ม และผลแกว่งตามความสุ่มของ LLM ต้องตั้งเกณฑ์เผื่อไว้
กันงบบานด้วย budget แยกให้ CI
CI รันทุก PR ถ้าวันหนึ่งมีคนเขียน loop พลาด ค่าใช้จ่ายอาจวิ่งโดยไม่มีใครเห็น AI Gateway ตั้ง budget แยกได้ระดับทีม, project, API key หรือสมาชิก ผมแนะนำให้สร้าง API key ใหม่สำหรับ CI โดยเฉพาะ แล้วตั้ง budget ให้ key นั้น
สิ่งที่ต้องรู้จากเอกสาร budgets:
- เกิน budget แล้ว request ถัดไปจะได้
402พร้อมtype: quota_for_entity_exceededด่านของเราจะนับเป็น error และล้ม ซึ่งดีกว่าผ่านแบบไม่มีใครรู้ - budget เป็น soft cap request ที่ข้ามเส้นยังทำงานจนจบ ยอดจริงเลยเกินนิดหน่อยได้
- รอบ
dailyรีเซ็ตเที่ยงคืน UTC ซึ่งคือ 7 โมงเช้าเวลาไทย ใครตั้ง daily budget แล้วสงสัยว่าทำไมตีสองยังไม่รีเซ็ต นี่แหละคำตอบ
เทียบโมเดลร่างคำตอบ: ผ่านด่านกี่ข้อต่อเงินที่จ่าย
ถ้าด่านตรวจเชื่อถือได้ระดับหนึ่งแล้ว เราใช้มันเป็นกรรมการเทียบโมเดลได้ src/04-compare-models.ts ให้โมเดลสองตัวร่างคำตอบให้ข้อความลูกค้าชุดเดียวกัน แล้วให้ Jev ตรวจ นับจำนวนที่ผ่าน และรวม gateway.cost แยกฝั่ง “ร่าง” กับฝั่ง “ตรวจ” ค่าเริ่มคือ google/gemini-2.5-flash-lite กับ openai/gpt-4o-mini เปลี่ยนได้ด้วย COMPARE_MODELS
ราคาต่อ 1 ล้าน token จาก catalog GET /v1/models ที่ผมดึงเมื่อ 26 ก.ย. 2026 (เปลี่ยนได้ทุกเมื่อ เช็กใหม่ก่อนใช้):
| โมเดล | input | output |
|---|---|---|
google/gemini-2.5-flash-lite | $0.10 | $0.40 |
openai/gpt-4o-mini | $0.15 | $0.60 |
typesafe-ai/jev | $0.042 | ไม่คิด |
ราคาของ Jev ตรงกับที่ The Register รายงาน ($0.042 ต่อล้าน input token และ $0 สำหรับ output) และตรงกับ gateway.cost ที่เราได้จริงทุก request ส่วนคำอ้างว่าถูกกว่าโมเดลใหญ่หลายร้อยเท่าเป็นตัวเลขของ TypeSafe เอง ในงานของเรา Jev ไม่ได้ถูกกว่า flash-lite (บทที่ 1 และ 2) เพราะคำถามกับ state ที่ยาวคือ input ทั้งหมด ด่านของเราวัดแค่ “ผ่านกี่ข้อ ต่อเงินที่จ่ายจริง” จากบิลของเราเอง
ผลรันจริง (26 ก.ย. 2026 21:28 น. เวลาไทย) ใช้เรท 33.345 บาทต่อดอลลาร์ (อัตราอ้างอิง ECB วันที่ 25 ก.ย. 2026 จาก Frankfurter) ส่งเข้าไปทาง THB_PER_USD ทั้งสองโมเดลใช้ได้กับบัญชีที่เพิ่งผูกบัตรและยังใช้เครดิตฟรีอยู่:
google/gemini-2.5-flash-lite: pass 4/5 | drafting 5 calls, gateway.cost total $0.00018130 ≈ ฿0.0060 (at 33.345 THB/USD), avg 809 ms | judging 5 calls, gateway.cost total $0.00018791 ≈ ฿0.0063 (at 33.345 THB/USD)
openai/gpt-4o-mini: pass 2/5 | drafting 5 calls, gateway.cost total $0.00030555 ≈ ฿0.0102 (at 33.345 THB/USD), avg 1134 ms | judging 5 calls, gateway.cost total $0.00018438 ≈ ฿0.0061 (at 33.345 THB/USD)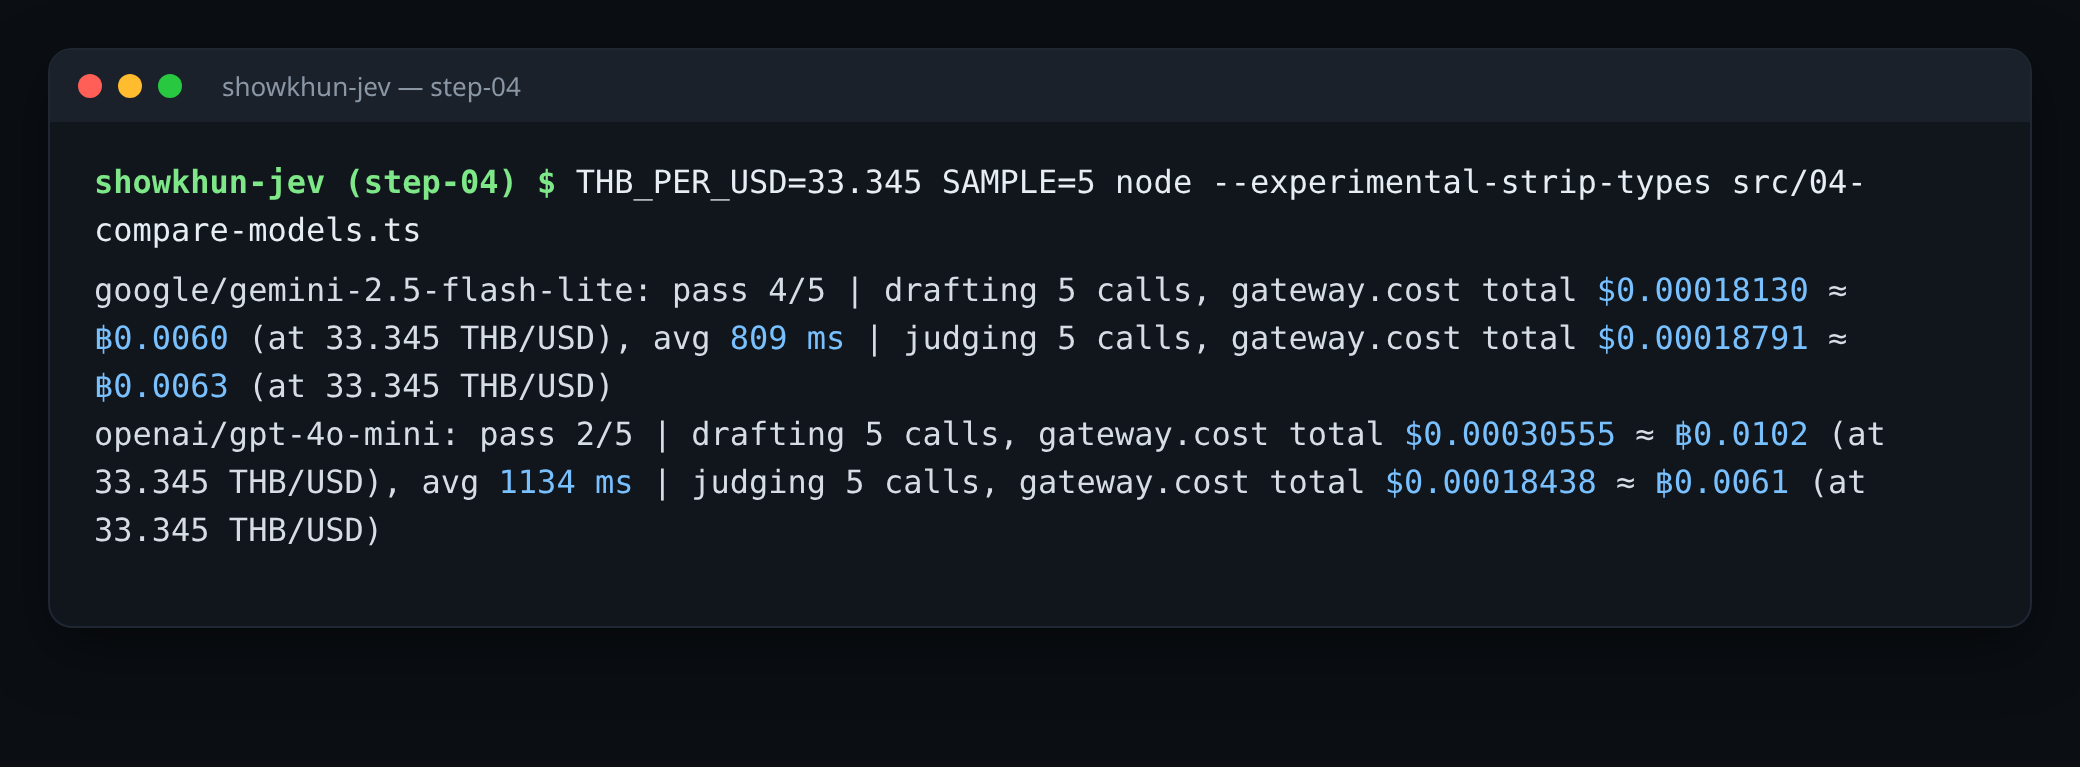
คิดเป็น “ต่อคำตอบที่ผ่านด่าน” (ค่าร่าง + ค่าตรวจ):
| โมเดลร่าง | ผ่าน | ค่าร่าง + ตรวจ | ต่อคำตอบที่ผ่าน | เวลาร่างเฉลี่ย |
|---|---|---|---|---|
google/gemini-2.5-flash-lite | 4/5 | $0.00036921 (≈ ฿0.0123) | ≈ ฿0.0031 | 809 ms |
openai/gpt-4o-mini | 2/5 | $0.00048993 (≈ ฿0.0163) | ≈ ฿0.0082 | 1,134 ms |
ในรอบนี้ flash-lite ถูกกว่า เร็วกว่า และผ่านด่านมากกว่า แต่อย่าเพิ่งเชื่อ: 5 ข้อต่อโมเดล รันครั้งเดียว และสคริปต์ยังไม่ได้พิมพ์ว่าข้อไหนตกเพราะอะไร (ควรเพิ่มก่อนใช้ตัดสินใจจริง) อีกเรื่องที่น่าสนใจคือ ค่าตรวจของ Jev (≈ $0.00018 ต่อ 5 ข้อ) พอๆ กับค่าร่างของ flash-lite ทั้งก้อน เพราะ state ที่ส่งให้ Jev มีทั้งนโยบาย ข้อความลูกค้า และร่าง รวมราว 900 token ต่อครั้ง
อ่านผลให้ระวัง: 5 ข้อน้อยมาก ถ้าโมเดล A ผ่าน 4 และ B ผ่าน 5 อาจเป็นแค่ดวง และกรรมการของเราก็เป็นโมเดลที่ผิดได้ ถ้าจะตัดสินใจเปลี่ยนโมเดลจริง ให้เพิ่มตัวอย่าง และสุ่มให้คนตรวจซ้ำบางส่วน
ค่าใช้จ่ายแฝงที่ควรรู้
โค้ดทุกขั้นส่ง tags ไปกับ request เพื่อแยกค่าใช้จ่ายตาม step ได้ แต่ หน้า pricing ระบุว่า Custom Reporting (ฟีเจอร์ที่ให้ query ตาม tag/user) เป็น add-on ที่ ปิดไว้เป็นค่าเริ่มต้น ถ้าเปิดจะคิด $0.075 ต่อ 1,000 writes (แต่ละ tag ต่อ request นับเป็นหนึ่ง write) และ $5 ต่อ 1,000 queries ผมยังไม่ได้ทดสอบว่าถ้าไม่เปิด add-on แล้ว tags จะถูกเก็บหรือคิดเงินหรือไม่ ใครไม่ต้องการ ลบ tags ออกได้เลย โค้ดทำงานเหมือนเดิม
ส่วนการดูภาพรวมแบบไม่เสียเงินเพิ่ม มี dashboard Observability และ Logs ที่บันทึก model, provider, token, latency และ cost ของทุก request อยู่แล้ว (Observability and Spend)
ข้อมูลที่ยังไม่ชัด
- เกณฑ์ 85% กับ “leak = 0” เป็นกติกาที่ผมเลือกเพื่อสอน ไม่ได้มาจากเอกสาร ร้านจริงควรเลือกจากต้นทุนของความผิดพลาดแต่ละแบบ
experimental_evaluateอาจเปลี่ยนใน patch release ตามที่ AI SDK ระบุ ด่านใน CI ควร pin เวอร์ชัน และรันเทส offline ก่อนทุกครั้ง (ซึ่ง workflow เราทำแล้ว)- ภาษาไทย: ยังไม่มีเอกสารทางการยืนยัน ผลของ workshop นี้ (คัดแยก 16/16, ด่าน 8/8, เคสประชดและปฏิเสธถูก) บอกว่าใช้ได้สมเหตุสมผล แต่ทั้งหมดเป็นข้อมูลที่ผมเขียนเอง ไม่ถึงร้อยข้อ ยังไม่ใช่การรับรอง
- ความเสถียร: วันที่ทดสอบเจอ
GatewayRateLimitErrorจาก upstream ของ Jev (บทที่ 2) ด่านใน CI ของเรานับ error เป็นการล้ม ถ้าเจอบ่อยจะได้ PR สีแดงแบบไม่ได้เกิดจากคุณภาพตก อาจต้องตั้ง retry ที่นานกว่าค่าเริ่ม หรือแยกสถานะ “ด่านรันไม่ได้” ออกจาก “คุณภาพตก”
สรุปบทนี้
- golden set คือคำตอบที่คนตัดสินไว้แล้ว ใช้เป็นมาตรฐานให้ Jev เทียบทุกครั้งที่แก้ prompt
- ด่านล้มเมื่อเห็นตรงกันน้อยกว่าเกณฑ์, มี leak หรือมี error รายงานตัวหารเสมอ
- key แยกสำหรับ CI + budget = กันงบบาน, 402 ทำให้ด่านล้มแทนที่จะเงียบ
- ใช้ด่านเดียวกันเทียบโมเดลได้ แต่ตัวอย่างน้อยอย่ารีบสรุป
สรุป workshop ทั้งชุด
สี่บทที่ผ่านมาเราได้:
- เรียก Jev ผ่าน AI Gateway ได้ทั้ง AI SDK 7 และ HTTP และอ่านคำตอบแบบ Choice / Score / Boolean ได้ถูก
- ตัวคัดแยกแชทที่รู้ว่าเมื่อไหร่ต้องส่งให้คน พร้อมเทส offline
- ตัวตรวจคำตอบของบอทที่ใช้นโยบายร้านเป็นหลักฐาน
- ด่านใน CI ที่กันคุณภาพตก พร้อม budget และวิธีเทียบโมเดลแบบคุ้มต่อบาท
สิ่งที่ยังต้องทำต่อในงานจริง: เพิ่ม golden set ให้ใหญ่พอ, เก็บคำตัดสินของแอดมินในระบบจริงมาเป็นป้ายคำตอบรอบถัดไป, และวัดใหม่ทุกครั้งที่เปลี่ยนคำถามหรือเปลี่ยนโมเดล
Recap
-
pnpm run gateรันได้ และล้มจริงเมื่อจงใจใส่คำตอบแย่ - workflow รันเทส offline ก่อนด่านจริง
- มี API key แยกสำหรับ CI พร้อม budget และ spend alert
- รู้ว่า daily budget รีเซ็ต 07:00 น. เวลาไทย
- เทียบโมเดลร่างคำตอบได้ และไม่สรุปจากตัวอย่าง 5 ข้อ
- ตัดสินใจเรื่อง
tags/ Custom Reporting แล้ว
Navigation
- ก่อนหน้า: Workshop #3: ให้ Jev ตรวจคำตอบของบอทก่อนส่งถึงลูกค้า
- โค้ดบทนี้: branch
step-04ในshowkhun-jev-workshop - ดูทั้งชุด: Jev Workshop